메커니즘(범용 재사용 가능한 커널)과 정책(교체 가능한 YAML)을 분리하는 것은 기본값이 아니라 의도적 선택이며, 이게 새 요구사항마다 재작성이 필요한 스크립트 모음과 그런 재작성 없이 살아남는 인프라의 차이를 만든다.
배경
Argus([2편](./02-argus-4month-failure.ko.md)의 다단계 파이프라인 프레임워크, [10편](./10-argus-universal-gate.ko.md)에서는 그 위의 범용 품질 게이트를 다뤘다)는 원래 등록된 프로젝트를 스케줄대로 실행하는 오케스트레이터였다. 그런데 리서치 파이프라인, 콘텐츠 자동화, 엔지니어링 모니터링, 개인 트래커 등 서로 무관한 여러 작업을 처리하는 자율/반자율 에이전트들이 같은 지식 저장소를 공유하며 늘어나자, Argus 위에서 "그냥 에이전트를 호출해서 알아서 하게 둔다"는 방식이 실제 문제를 일으키기 시작했다.
증상 — 세 가지 실패 패턴
- 소유권 경계 부재. 어떤 에이전트든 저장소의 어떤 경로에도 쓸 수 있었다. 서로 다른 도메인의 에이전트 십수 개가 반자율로 실행되기 시작하자, 리서치 작업 에이전트가 콘텐츠 파이프라인 소유 파일을 덮어쓰거나 모니터링 스크립트가 다른 도메인의 작업 큐에 잘못 쓰는 일이 생겼다 — 악의가 아니라 "경로에는 소유자가 있다"는 개념 자체가 없었기 때문이다.
- 라우팅 계약 부재. 새 작업이 어떤 전담 핸들러로 가야 하는지가 그 작업을 시작한 스크립트에 우연히 들어있던 애드혹
if로직으로 결정됐다. "패턴 X는 핸들러 Y로"를 명시하는 단일한 검사 가능 지점이 없었다. - 메모리 보존 정책 부재. 모든 실행, 모든 추출된 사실이 구분 없이 같은 저장소에 쌓였다. "최근 것"과 "6주 전 배경 맥락"을 구분할 방법이 없었다.
첫 시도 — 그리고 왜 안 됐나
첫 본능은 실패가 나타난 곳마다 땜질하는 것이었다: 오작동한 스크립트 하나에 수동 경로 체크를 추가하고, 새 도메인마다 라우팅에 elif를 하나씩 더하고, 저장소가 버거워질 때마다 일회성 정리 스크립트를 돌렸다. 예측 가능한 이유로 실패했다 — 수정이 공유된 계약이 아니라 증상 옆에 붙어 있었기 때문이다. 스크립트 A에 경로 체크를 추가해도 스크립트 B가 다음 주에 같은 실수를 하는 걸 막지 못했다. 완전히 다른 도메인의 리서치 노트를 덮어쓴 두 번째 사건 이후, 문제는 "가드 절 하나 더"가 아니라 아키텍처라는 게 분명해졌다 — 모든 에이전트의 읽기/쓰기/디스패치가 반드시 거쳐야 하는 단일 관문(choke point)이 없었다.
조사 — OS 어휘를 빌려오다
재구성의 핵심은 "에이전트 레이어"를 명시적으로 커널로 모델링하는 것이었다. 새로운 에이전트 전용 추상화를 발명하는 대신, 실제 OS 커널의 세 가지 기본 요소 — syscall, 인터럽트, 메모리 계층 — 를 그대로 가져왔다. 메모리 보호, 인터럽트 벡터링, 페이징/보존 정책은 운영체제가 존재하는 교과서적 이유다. 충분한 동시 작업을 처리하는 애드혹 에이전트 레이어는 사실상 아직 설계되지 않은 작은 OS라는 걸 인식하는 게 기술적 참신함보다 중요했다.
직접 파일 접근이 아닌 syscall. 직접적인 저장소 접근을 작은 syscall 스타일 API(kb_write, kb_read, kb_write_batch, take_write, spawn)로 완전히 대체했다. 공유 상태를 건드리는 모든 동작은 이 API를 거친다 — 유일한 출입문인 체크는 우회할 수 없다.
커지는 조건문이 아닌 인터럽트 테이블. Interrupt / InterruptKind / InterruptRouter 추상화를 만들었다. 들어오는 작업은 종류별(도메인 특화, 자가 치유/재시도, 패턴 일반화, 폴백 합성)로 분류되고, 라우터는 CPU의 인터럽트 벡터 테이블처럼 조회 테이블을 통해 핸들러를 찾는다 — 매 신규 케이스마다 코드 변경이 필요한 if 체인이 아니라.
정책을 가진 계층형 메모리. hot/warm/cold 세 티어를 가진 MemoryLayer를 TierConfig(시간 단위 나이 임계값)로 제어한다. 읽기는 기본 "auto" 모드로 warm→hot을 훑고 cold는 명시적으로 제외한다. cold 데이터는 삭제되지 않고 우선순위만 낮아진다.
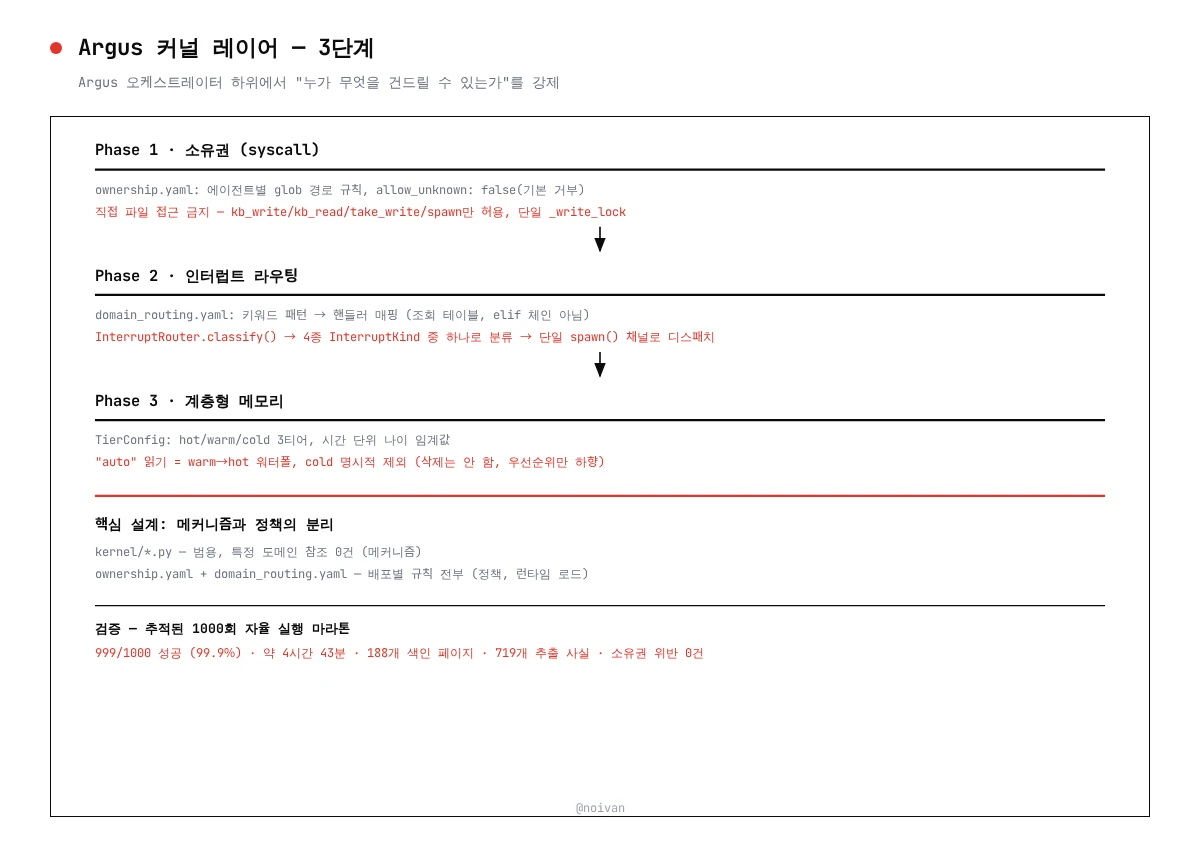
세 단계를 관통하는 가장 깊은 결정은 커널과 정책의 경계였다. "이게 내 도메인, 이게 내 에이전트의 허용 경로"를 코드에 하드코딩하는 게 훨씬 빨랐을 것이다. 의도적으로 그렇게 하지 않았다: 배포별 규칙(어떤 에이전트가 어떤 glob 패턴을 소유하는지, 어떤 키워드가 어떤 핸들러로 가는지, hot 상태를 얼마나 유지하는지)은 전부 커널이 런타임에 로드하는 외부 YAML(ownership.yaml, domain_routing.yaml)에 둔다. 커널 패키지(kernel/syscall.py, kernel/ownership.py, kernel/interrupt.py, kernel/memory.py) 자체는 특정 도메인을 전혀 참조하지 않는다. 새 도메인 추가는 커널 변경이 아니라 YAML 엔트리 하나를 의미한다.
해결책 — 3단계 커널
1단계(소유권): ownership.yaml이 에이전트별 glob 패턴 규칙을 정의하며 allow_unknown: false가 기본 거부 정책이다. _validate_path()는 규칙 검사 이전에 경로 순회, 절대 경로, 빈 문자열, 과대 입력을 차단한다. 모든 변경 호출에 단일 _write_lock이 일관 적용되고, 배치 쓰기는 하나의 트랜잭션으로 묶인다.
2단계(라우팅): domain_routing.yaml이 키워드 패턴을 핸들러로 매핑한다. InterruptRouter.classify()가 최근 활동을 소수의 InterruptKind로 분류하고 단일 spawn() 채널로 디스패치한다. 핸들러를 직접 실행할 수도, 라우터가 동시에 픽업할 수도 있었던 기존의 이중 경로 실행 구조를 제거해 이중 실행 경쟁 상태를 없앴다.
3단계(메모리): TierConfig가 hot/warm 경계를 시간 단위로 설정한다. MemoryLayer는 티어 인지 읽기, 티어 분류기(tier_of), 요약 뷰(summarize())를 제공해 메모리 상태를 불투명한 대상이 아니라 조회 가능한 대상으로 만든다.
Before / After
# Before: 소유권 경계도, 검증도, 락도 없음
def agent_save_result(path: str, content: str) -> None:
    with open(path, "w") as f:
        f.write(content)

agent_save_result("shared_store/content_pipeline/queue.md", result_text)

# After: syscall 스타일 API가 소유권 + 검증 + 락을 강제
from kernel import get_kernel

kernel = get_kernel()
kernel.kb_write(
    path="shared_store/content_pipeline/queue.md",
    content=result_text,
    agent="research_agent",
)  # ownership.yaml에 규칙 없으면 PermissionError,
   # 경로 순회/절대경로/빈입력이면 ValueError
"Before" 버전은 "이 에이전트는 이 경로를 건드리면 안 된다"는 개념 자체를 표현할 방법이 없다 — 규칙은 주석이나 기억 속에만 존재한다. "After" 버전은 그 규칙을 일급 객체로 만들어, 어떤 에이전트가 시작하든 모든 단일 쓰기에서 강제한다.
검증
설계 리뷰만으로는 커널이 견고한지 증명되지 않는다. 각 단계는 통합 전 자체 pass/fail 체크(경로 순회 차단, 소유권 규칙 강제, 인터럽트 분류 정확성, 티어 경계 정확성)를 거쳤지만, 진짜 검증은 완성된 커널 위에서 진행한 추적된 완전 자율 1000회 실행 마라톤이었다.
| 지표 | 결과 | |---|---| | 총 실행 | 1,000회 | | 성공 | 999회 (99.9%) | | 실패 | 1회 (0.1%) | | 소요 시간 | 약 4시간 43분 |
이 실행 동안 지식 축적 파이프라인이 188개의 색인된 페이지와 719개의 추출된 사실을 만들어냈고, 수동 정리도 소유권 위반도 없었다 — 천 번의 독립 실행에 걸쳐서다. 999/1000은 참이거나 거짓이거나 둘 중 하나이며 실행 로그로 검증 가능한 반증 가능한 수치다.
개인용 에이전트 시스템을 만드는 대부분의 사람은 자기 규칙을 코드에 바로 하드코딩한다 — 더 빠르고 만족시켜야 할 배포 환경이 하나뿐이기 때문이다. 메커니즘(범용 재사용 가능한 커널)과 정책(교체 가능한 YAML)을 분리하는 것은 기본값이 아니라 의도적인 선택이며, 이게 새 요구사항마다 재작성이 필요한 스크립트 모음과 그런 재작성 없이 살아남는 인프라의 차이를 만든다. Argus가 원래 다단계 파이프라인 오케스트레이터로 시작했다는 걸 생각하면([2편](./02-argus-4month-failure.ko.md)), 이번 커널 레이어는 그 위에서 도는 "무엇을(what)"이 아니라 "누가 무엇을 건드릴 수 있는가(who)"를 강제하는 하위 레이어다 — 스케줄링되고 격리되는 대상이 OS 스레드가 아니라 자율적인 LLM 기반 작업이라는 점만 다를 뿐, 새로운 도메인의 확장성 문제가 구조적으로는 이미 오래된 분야가 풀어낸 문제와 같다는 걸 인식하고 그 어휘와 해법을 가져다 쓰는 것이 핵심이었다.
첫 댓글을 남겨보세요