잘못된 지표를 선택 알고리즘에 먹이면 자신만만하게 틀린 결정이 나온다 — 그 위에 무언가를 쌓기 전에 측정 계층 자체를 독립적인 진실 소스와 대조해 검증하는 게 언제나 먼저다.
배경
[22편](./22-persona-autonomous-ops.ko.md)이 끝날 무렵 Project Persona는 매일 최소 개입으로 두 트랙에서 콘텐츠를 생성·검증·게시할 수 있었다. 의미 있는 이정표지만 여기서 멈추면 함정이다: 사람 없이 돌아가지만 자기가 만든 결과물을 절대 되돌아보지 않는 파이프라인은 추측을 더 빠르게 자동화하는 것일 뿐이다. 어떤 훅 스타일을 쓸지, 어떤 소재를 좇을지는 지난 열 편이 실제로 잘 됐는지와 무관하게 매번 같은 방식으로 결정되고 있었다. 루프를 닫아야 했다: 성과 데이터를 실제로 다시 끌어오고, 그 데이터를 신뢰할 수 있는지 먼저 검증하고, 작은 표본을 과대해석하지 않는 것.
첫 시도와 그 한계
"성과 데이터를 활용한다"의 첫 버전은 지나치게 단순했다: 스케줄에 따라 플랫폼 Analytics API를 조회해 조회수/시청시간을 기록하는 것으로 끝. 이건 루프가 아니라 로그 파일이다. 이어서 "니치 성과 보너스"를 소재 선택 스코어링 함수에 곱하는 방식으로 첫 진짜 시도를 했다 — 역사적으로 잘 됐던 니치는 가중치를 높이고 못했던 니치는 낮추는 식. 크래시 없이 돌아갔지만, 실제 동작을 리뷰하니 신뢰를 위험하게 만드는 문제 두 가지가 드러났다: 기반 숫자 자체가 항상 진짜가 아니었고, 작은 표본이 확신에 찬 신호처럼 취급되고 있었다.
조사 — 숫자가 안 맞는 이유
Analytics API가 보고한 조회수와 플랫폼 자체의 공개 영상-카운트 API를 교차확인하니 실제 불일치가 드러났다: Analytics API는 한 영상에 views = 0을 반환했는데, 공개 API는 실제 조회수 5를 확인해줬다. 분석 플랫폼 문서를 읽다가 놓치기 쉬운 정책을 발견했다 — 트래픽이 매우 적은 영상은 프라이버시 보호 조치로 행 단위 데이터 자체가 완전히 억제될 수 있다는 것. 해당 영상에 대해 엔드포인트를 직접 호출해 확인해보니 응답은 0이 아니라 빈 결과 집합이었다 — 파이프라인 로깅 코드가 "데이터 없음"을 "조회수 0"으로 잘못 해석하고 있었고, 그 오해석이 다음에 뭘 만들지 결정하는 스코어링 로직으로 곧장 흘러들어가고 있었다. 신규 채널이 가장 많이 만들어내는 바로 그 저트래픽 영상들에 대해, 지표가 체계적으로 틀릴 수 있는 조용한 경로였다.
비슷한 시기에 훅 스타일 추적 감사에서 관련 없는 두 번째 버그가 드러났다. 훅 타입별 성과를 집계하는 분석 모듈이 잘못된 필드명을 쓰는 매핑 테이블 위에 만들어져 있었다. 4가지 훅 타입 값 전부를 대입해 테스트해보니 4개 중 3개가 조용히 기본값으로 떨어지고 있었다 — 진짜 하나의 카테고리를 나머지 세 개가 뒤섞인 덩어리와 비교하는 셈이었다. 두 버그를 관통하는 패턴은 같다: 그 지표를 만든 코드 경로가 독립적인 진실 소스와 일치한다는 걸 검증하기 전까지는 지표를 신뢰하지 마라.
해결책 — 무결성 체크포인트를 1급 단계로
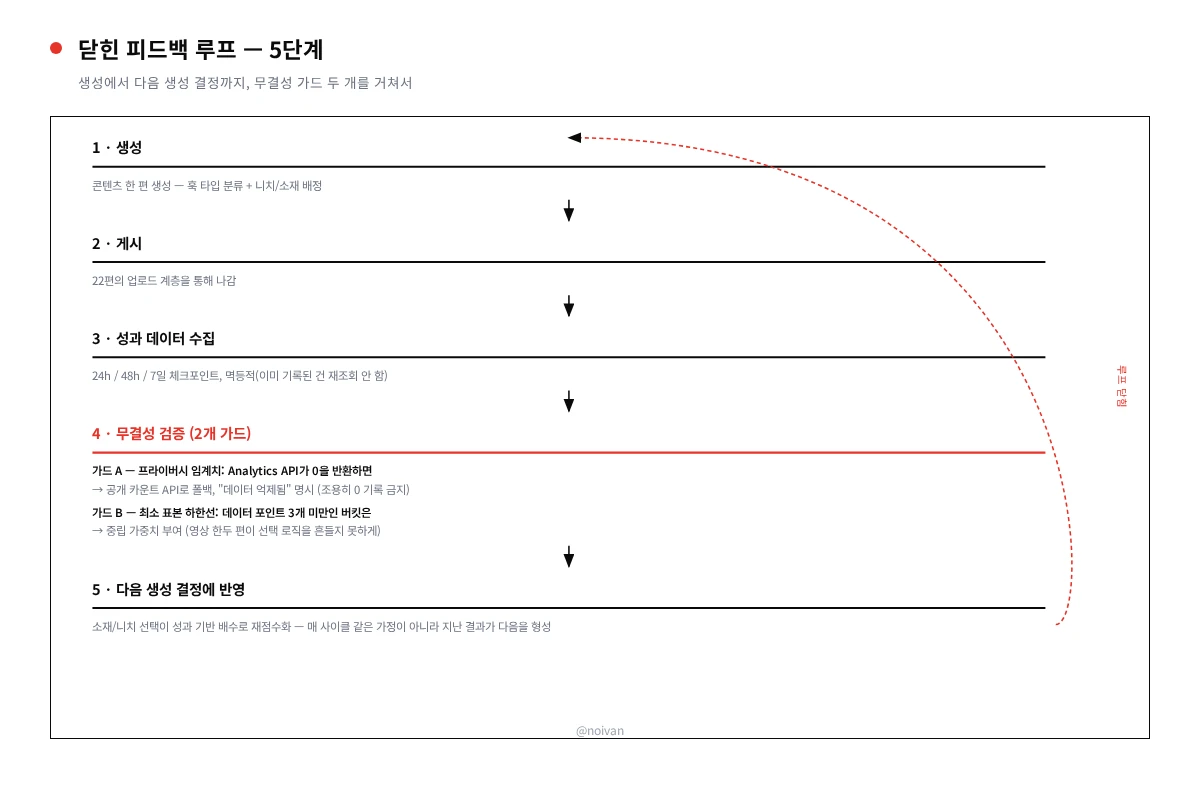
결과물은 측정 무결성 체크가 부차적인 게 아니라 첫 시민으로 내장된 닫힌 루프다: 생성(훅 타입·니치 라벨링 포함) → 게시 → 성과 데이터 수집(24h/48h/7일 체크포인트, 멱등적) → 두 가지 무결성 가드를 갖춘 분석 → 다음 생성 결정 반영. 프라이버시 임계치 처리는 억제된 결과가 오면 공개 카운트 API로 폴백해 최소한 정확한 원시 조회수를 확보하고, 조용히 0을 기록하는 대신 명시적으로 "데이터 억제됨"으로 표시한다. 최소 표본 하한선은 데이터 포인트가 3개 미만인 니치/훅타입 버킷을 통계적으로 아직 입증되지 않은 것으로 취급해 중립 가중치를 부여한다 — 영상 한두 편의 힘만으로 선택 로직을 흔들지 못하게.
Before / After: 트렌드 분류
소재 분류는 원래 고정 키워드 목록에 대한 부분문자열 매칭이었다. 새로운 오분류가 나올 때마다 마커를 하나씩 더 추가하는 식이었는데, 세 라운드를 거치자 특수 케이스 마커가 8개 이상으로 불어났고, 문제가 특정 누락 키워드가 아니라 접근법 자체임이 명백해졌다.
# Before — 새 오분류가 나올 때마다 마커를 반응적으로 추가
NICHE_KEYWORDS = {
    "reversal_comedy": ["twist", "unexpected", "plot twist"],
}
GENRE_MISMATCH_MARKERS = ["relatable", "emotional", "recipe tutorial"]

def classify_niche(title: str) -> str | None:
    if any(m in title.lower() for m in GENRE_MISMATCH_MARKERS):
        return None
    for niche, kws in NICHE_KEYWORDS.items():
        if any(k in title.lower() for k in kws):
            return niche
    return None

# After — LLM 배치 분류기, 실패 시 기존 키워드 분류기로 폴백
def classify_niches_batch(candidates):
    try:
        return parse_batch_response(call_classification_llm(candidates))
    except (TimeoutError, RateLimitError, APIError):
        return {c.id: classify_niche(c.title) for c in candidates}
문자열 매칭이 "이 제목이 이 단어를 포함하는가"를 묻는다면, 새 분류기는 "이 콘텐츠가 실제로 반전/에스컬레이션 코미디 구조를 보여주는가"를 묻는다 — 제목이 어떤 단어를 우연히 썼는지와 무관하게. 실제 후보 소재 106개 배치로 검증: 키워드 전용 접근법은 10개를 식별했고, LLM 기반 분류기는 25개를 식별했다 — 2.5배 증가. 새로 드러난 후보들을 수동 검토하니 실제로 콘텐츠 구조에 잘 맞는다는 게 확인됐다.
훅 감사 — 4개 계층, 하나의 간극
숏폼의 첫 몇 초("훅")는 전체 제작 과정에서 단일 최고 레버리지 구간이다. "괜찮아 보인다"는 단일 체크를 믿는 대신 기획·평가·생성·제시 네 계층 전부를 감사했다. 계층 2(평가)와 4(제시)는 문제없었다. 계층 1(기획)에서 진짜 간극을 발견했다: 기획자는 각 콘텐츠에 4가지 훅 타입 중 하나를 정확히 라벨링했지만, 오프닝 씬 생성 지시문은 그 라벨을 시각적으로 어떻게 구현할지 전혀 알려주지 않았다. "전제 모순" 훅 타입이 "차분하고 화창한 사무실"이라는 지시를 만들어냈는데, 스토리와는 일관되지만 그 훅 타입이 신호를 보내야 할 시각적 긴장감이 전혀 없었다. 계층 3(생성 결과물이 독립적으로도 강한 훅으로 읽히는지 검증) — 은 알고 보니 공식 검사로 아예 존재하지 않았다. 이건 아직 추적 중인 간극이다: 4계층 중 3계층을 만들고 나면 전체가 다 커버됐다고 믿기 쉽다.
검증
- Analytics API 조회수(0)와 공개 카운트 API(5) 불일치를 확인하고 프라이버시 임계치 억제로 원인을 추적, 폴백 경로가 이제 "데이터 억제됨" 플래그와 함께 정확한 카운트를 보고함을 검증했다.
- 훅 타입-성과 매핑을 4가지 실제 값 전부에 직접 테스트: 수정 전엔 4개 중 3개가 같은 기본값, 수정 후엔 4개 모두 정확히 매칭됨을 확인했다.
- LLM 분류기를 실제 후보 106개로 실행해 식별 후보가 10개→25개로 증가함을 확인하고, 새 후보들의 장르 적합성을 수동 표본 검토했다.
- 최소 표본 하한선이 경계에서 올바르게 동작함을 확인했다: 데이터 포인트 3개 미만 버킷이 극단값이 아니라 중립 배수를 반환했다.
지표가 컴파일되고 숫자를 반환한다는 이유만으로 자신의 계측을 맹신하지 않는 규율이 이번 편의 핵심이다. 두 번이나 그럴듯해 보이는 지표가 알고 보니 잘못된 것을 측정하고 있었고, 두 번 다 중요했던 수정은 더 나은 선택 알고리즘이 아니라 측정 계층 자체를 독립적인 진실 소스와 대조해 검증하러 돌아가는 것이었다. 규칙 기반 휴리스틱이 한계에 도달했음을 인식하고 모델 기반 접근으로 교체할 가치가 있는 순간과, 단순한 규칙이 여전히 옳은 도구인 순간을 구분하는 것 — 그리고 새 접근법에 신뢰성을 전부 걸지 않고 그 단순한 규칙을 폴백으로 남겨두는 것까지가 전이 가능한 판단력이다.
---
이 글은 완전 자율 콘텐츠 파이프라인 구축기 4부작 중 마지막 편이다. [20편](./20-persona-pipeline-architecture.ko.md)은 5-레이어 아키텍처를, [21편](./21-persona-qc-consistency.ko.md)은 QC 게이트를, [22편](./22-persona-autonomous-ops.ko.md)은 무인 운영을 다뤘다. 네 편을 관통하는 진행은 하나다: 아키텍처를 설계하고, 품질 게이트를 내장하고, 무인으로 돌아가게 만든 다음, 측정할 무언가가 생기고 나서야 비로소 루프를 닫아 실제 결과가 다음에 만들어질 것을 형성하도록 하는 것.
첫 댓글을 남겨보세요