상태 코드 하나만으로 성공을 판단하지 않고 콘텐츠를 검증한 뒤에만 에스컬레이션하면, 유료 API 없이도 정직하게 실패하는 리서치 인프라를 만들 수 있다 — 모든 사이트를 뚫는 만능 해법은 아니라는 것까지 포함해서.
배경
AI 기반 리서치가 실제로 엔드투엔드로 동작하길 원했다 — 웹을 검색하고, 전체 페이지 콘텐츠를 수집하고, 신뢰할 수 있는 답변으로 종합하는 것. 가장 손쉬운 길은 호스팅형 검색+추출 API 하나를 붙이고 넘어가는 것이다. 그 길은 막혀 있었다. 아웃바운드 정책이 엄격한 네트워크 안에서 작업하고 있었고, 특정 벤더가 안 되는 이유를 네트워크 탓으로 추정하고 넘어가고 싶지 않아서 직접 확인했다. 해당 벤더의 API 도메인에 curl 요청을 보내자 API 에러가 아니라 사내 웹필터의 차단 페이지로 향하는 HTTP 리다이렉트가 돌아왔다. 마케팅 사이트, 문서, API 엔드포인트 전부가 같은 차단 페이지로 갔다 — 도메인 단위 차단이라 API 키를 발급받아도 소용없었다.
이어서 더 명확한 제약이 나왔다: 기술적으로 접근 가능한 벤더라도 유료 API는 전부 배제, 신규 유료 계정 생성 금지, 무료·오픈소스만. 진짜 요구사항이 "벤더 하나 우회하기"에서 "벤더 의존성이 전혀 없는 리서치 파이프라인 구축하기"로 바뀌었다.
첫 시도와 그 한계
"무료"가 제약일 때 본능적으로 떠오르는 건 자체호스팅이다. 잘 알려진 오픈소스 메타서치 엔진을 컨테이너로 띄우고 여러 공개 검색 백엔드 결과를 취합하는 방식을 첫 시도로 구성했다. 컨테이너는 기동됐지만 안의 모든 검색 백엔드가 즉시 인증서 검증 오류로 실패했다. 사내망의 TLS 검사(아웃바운드 HTTPS를 사내 루트 인증서로 재서명해 검사하는 표준 기업 보안 구성)가 Docker 컨테이너 내부 트래픽에도 적용됐는데, 컨테이너의 Python 신뢰 저장소엔 그 루트 인증서가 없어서 CERTIFICATE_VERIFY_FAILED가 났다.
알려진 해법(루트 CA를 컨테이너에 주입)을 준비까지 마쳤지만, 재시작이 보안 승인 대기열에 걸린 사이 더 근본적인 질문이 떠올랐다: 이 컨테이너가 정말 필요한가? 이미 구축 중이던 AI 도구 플랫폼에는 무료·무가입으로 동작하는 웹 검색 기능이 이미 있었다. 뭐가 이미 되고 있는지 확인하지도 않고 곧바로 "새 인프라를 세운다"로 직행한 전형적인 과잉 엔지니어링 함정이었다. 컨테이너를 중지·제거했다. 다시 들여다본 진짜 공백은 검색이 아니라 전체 페이지 콘텐츠 추출이었다.
조사 — 3단계로 정착하기까지
범위를 "추출 문제"로 좁힌 뒤, 문서의 주장을 믿지 않고 직접 테스트하며 무료로 페이지 콘텐츠를 안정적으로 가져올 방법을 찾았다.
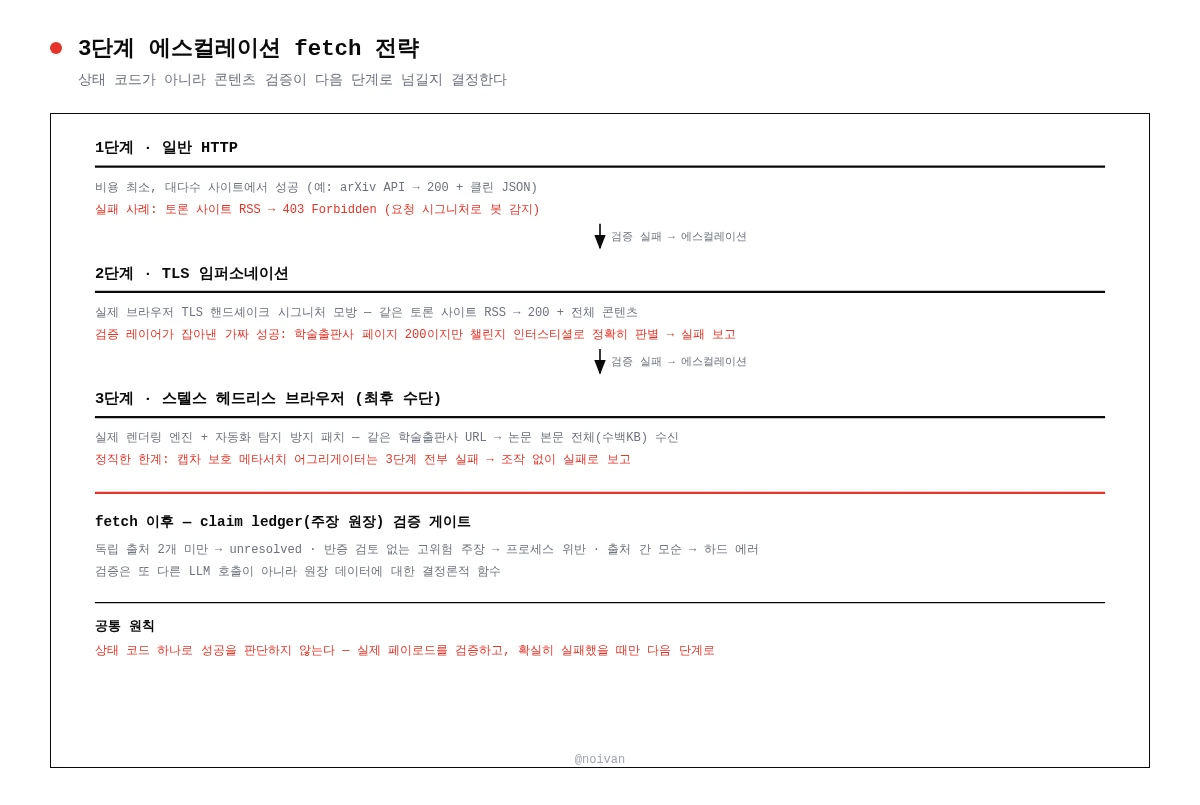
1단계 — 일반 HTTP. arXiv API 같은 곳은 첫 시도에 깔끔한 XML/JSON을 반환한다. 하지만 잘 알려진 한 토론 사이트의 RSS 피드는 일반 HTTP 클라이언트에 403을 반환했다 — 콘텐츠를 내주기도 전에 요청 시그니처(헤더, TLS 지문)로 봇을 감지한 것.
2단계 — TLS 임퍼소네이션. 실제 브라우저의 TLS 핸드셰이크 시그니처를 모방하는 라이브러리로 같은 URL을 요청하자, 그 RSS 피드가 200과 함께 전체 콘텐츠를 반환했다. 이 라이브러리엔 검증 레이어도 있다 — 단순 200을 성공으로 믿지 않고, "브라우저 확인 중" 같은 인터스티셜 챌린지 마커를 검사한다. 한 학술 출판사 논문 페이지에서 이게 바로 작동했다: 응답은 200이었지만 검증기가 이를 봇 챌린지 인터스티셜로 정확히 판별해 조용히 쓰레기 값을 반환하는 대신 정직하게 실패를 보고했다.
3단계 — 스텔스 헤드리스 브라우저. 위 학술 출판사 URL을 실제 렌더링 엔진 + 자동화 탐지 방지 패치를 적용한 헤드리스 브라우저로 재시도하자 실제 논문 페이지 전체(수백 KB의 진짜 HTML)가 돌아왔다.
한계도 정직하게. 캡차 뒤에 결과를 숨긴 광고 기반 메타서치 어그리게이터는 완전한 스텔스 브라우저 에스컬레이션까지 동원해도 뚫지 못했다. 도구는 이를 거짓 성공 처리하지 않고 정확히 실패로 보고했다. 3단계 전체를 관통하는 공통 패턴: 상태 코드 하나만으로 성공을 판단하지 않고, 실제 페이로드를 검증하고, 정말 실패했을 때만 에스컬레이션한다.
해결책 — 검증 게이팅된 3단계 fetch + claim ledger
최종 설계는 콘텐츠 검증으로 게이팅되는 3단계 에스컬레이션 fetch 함수다. 모든 단계가 실패하면 조작된 성공 대신 명시적인 실패를 반환한다.
fetch 레이어에서 멈추지 않았다. 각각 수만 개의 GitHub 스타를 가진 유명 오픈소스 딥리서치 프로젝트 3개의 실제 소스코드를 읽으면서 — README가 아니라 코드 레벨에서 — claim ledger(주장 원장) 패턴을 발견했다: 모든 사실 주장을 근거 출처와 함께 기록하고, 별도의 결정론적 검증 단계가 각 주장이 실제로 수집된 출처까지 추적 가능한지 검사해 pass/fail을 내린다. 중요한 건 이 검증이 또 다른 LLM 호출이 아니라 평범한 코드라는 점 — pass/fail은 원장 데이터에 대한 함수 결과다.
이 패턴을 재구현하며 세 가지 판정 규칙을 넣었다: 독립 출처 2개 미만이면 "unresolved"로 표시, 반증 검토 없이 고위험 주장이 나오면 프로세스 위반으로 처리, 출처끼리 모순되면 명시적 하드 에러로 처리한다.
Before / After: fetch 함수
# Before — 단일 방식, 검증 없음
import requests

def fetch_page(url: str) -> str:
    response = requests.get(url, timeout=10)
    response.raise_for_status()
    return response.text  # 버그: 200 상태의 챌린지 페이지가 그대로 통과

# After — 단계마다 콘텐츠 검증기로 게이팅
def looks_like_challenge_page(status_code: int, body: str) -> bool:
    markers = ("verifying your browser", "checking your connection", "captcha")
    if status_code >= 400:
        return True
    return len(body) < 800 and any(m in body.lower() for m in markers)

def resilient_fetch(url: str) -> FetchResult:
    for fetch_fn in (fetch_plain, fetch_tls_impersonated, fetch_stealth_browser):
        result = fetch_fn(url)
        if result.ok:
            return result
    return FetchResult(False, None, tier_used="none", reason="unreachable_all_tiers_exhausted")
검증
- 1→2단계 실제 사례: 토론 사이트 RSS가 일반 HTTP엔 403, TLS 임퍼소네이션엔 200+전체 콘텐츠.
- 콘텐츠 검증이 잡아낸 실제 사례: 학술 출판사 페이지가 TLS 임퍼소네이션에 200을 반환했지만 검증기가 봇 챌린지로 정확히 분류.
- 2→3단계 에스컬레이션, 동일 URL: 스텔스 브라우저 단계에서 실제 논문 본문 전체 수신.
- 정직한 한계: 캡차 보호 어그리게이터는 전 단계 실패, 조작 없이 실패로 정확히 보고.
- claim-ledger 재구현판을 검증된 주장/반증 누락/단일 출처/직접 반증된 주장으로 구성한 테스트로 실행 — 각각 verified/unresolved/refuted로 정확히 분류, 프로세스 위반 케이스는 0이 아닌 exit code를 트리거.
"대체로 잘 동작하는 fetch 함수"를 이어붙이는 것과, 실패할 때 정직하게 실패하는 인프라를 만드는 것은 다른 일이다. 핵심 역량은 어떤 라이브러리를 골랐느냐가 아니라, 실제 오픈소스 코드베이스를 소스코드 레벨에서 읽고 재사용할 가치가 있는 설계 패턴을 추출하는 능력, 인프라에 대한 베팅이 성과를 못 내고 있다는 걸 알아차리고 매몰비용에 끌려가는 대신 손절하는 판단력, 그리고 AI가 만든 결과물을 그냥 믿는 대신 리서치 도구 자체에 검증을 내장하는 설계다. 참고로 이 리서치 도구는 [16편](./16-adversarial-audit.ko.md)에서 다룬 이중 에이전트 감사 체계가 정기적으로 점검하는 시스템 중 하나이기도 하다 — 검증을 내장한 도구조차, 그 도구 자체가 별도의 독립적 검증 대상이 되는 것이다.
---
제약 조건에서 출발하는 설계와 정직한 실패 모드는 특정 API에 대한 접근권보다 훨씬 오래 남는 자산이다.
첫 댓글을 남겨보세요