제품 카테고리를 소개 문구가 아니라 실제 API 구조로부터 다시 도출하자, '과포화 시장'이라는 결론이 가장 인기 있는 에이전트 그래프 프레임워크의 실재하는 미해결 틈새로 바뀌었다.
배경
이미 완성해서 운영 중이던 SaaS 제품이 하나 있었다. 여기서는 Compass라고 부르겠다. 내부 구조는 FastAPI + PostgreSQL + Redis + 백그라운드 워커, 멀티테넌트 인증, Stripe 결제, 비주얼 워크플로우 빌더, 템플릿 마켓플레이스까지 갖춘 프로덕션급 제품이었다. 이 이야기가 시작되는 시점에는 PRD가 완료되어 있었고, 테스트 1,400건 이상 통과, 커버리지 약 75%, OWASP A01~A10 보안 점검까지 끝난 상태였다.
기능적으로 보면 Compass는 n8n, Zapier, Make를 써본 사람이라면 바로 알아볼 법한 "워크플로우를 시각적으로 구성해 자동화하는" 도구였다. 당시엔 부가기능 정도로만 여겼던 기능이 하나 있었는데, 워크플로우 그래프를 실제로 실행하기 전에 도달 불가능한 단계, 순환 참조, 규칙 커버리지 누락 같은 구조적 문제를 점검해주는 엔드포인트였다.
정작 풀어야 할 질문은 기술적인 게 아니었다. 이걸 계속 밀고 갈 가치가 있는가, 피벗해야 하는가, 아니면 접어야 하는가.
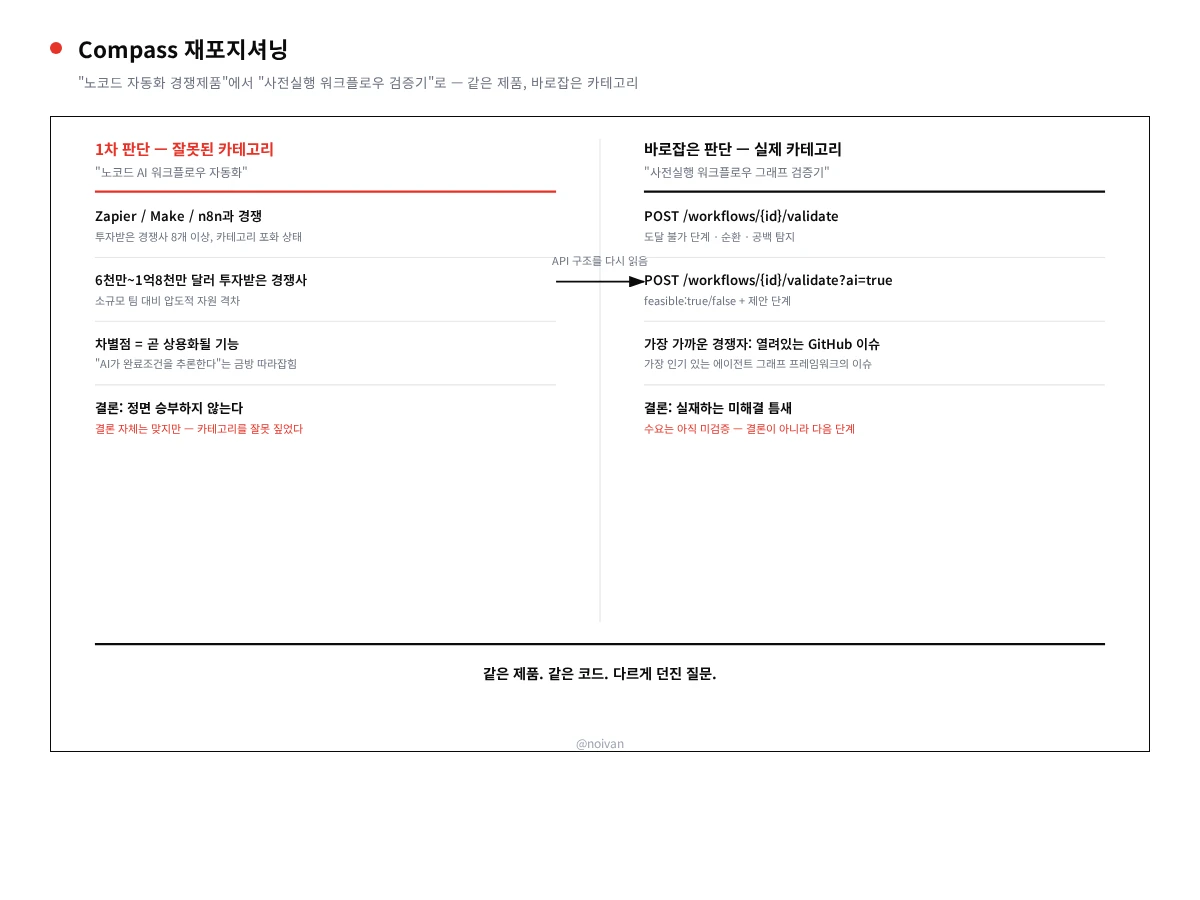
1차 분석 — 잘못된 카테고리
대부분이 그렇듯 나도 겉으로 가장 비슷해 보이는 제품군과 비교하는 것부터 시작했다. 그렇게 하니 Compass는 곧바로 "노코드 AI 워크플로우 자동화" 카테고리에 들어갔고, Zapier·Make.com·n8n, 그리고 그 해에 쏟아져 나온 여러 AI 에이전트 빌더 도구들과 정면으로 경쟁하는 구도가 되었다.
당시 조사한 수치는 이랬다.
- 이 카테고리(에이전틱 AI 워크플로우 오케스트레이션)는 소스에 따라 당해년도 기준 27억~39억 달러 규모로 추정됐고, CAGR 20~44%대의 확실한 고성장 시장이었다.
- 문제는 경쟁 밀도였다. n8n 하나만 봐도 수억 달러 규모의 라운드를 유치하며 기업가치가 수십억 달러대에 이르렀다는 보도가 있었고, 그 외에도 AI 네이티브 노코드 빌더 5~6개가 똑같은 고객을 두고 경쟁하고 있었다.
- 그 시점의 결론: 정면승부는 하지 말아야 한다. 1인 + AI 에이전트 체제와 3,000만~1억8,000만 달러 규모의 자금을 가진 경쟁자 사이의 격차는 포지셔닝을 잘한다고 메워지는 게 아니다.
그와 별개로 Compass를 독립 제품이 아니라, 다른 프로젝트에서 이미 쓰고 있던 내부 자동화 엔진에 "기능 업그레이드"로 흡수하는 안도 잠깐 검토했다. 이때는 아이디어만으로 판단하지 않고 실제 그 엔진 코드(약 700줄)를 직접 대조했는데, 이미 완전히 다른 실행 모델(워크플로우 그래프 실행이 아니라, 실제 터미널/ 파일/git 작업을 수행하는 LLM 서브에이전트 오케스트레이션)을 위한 자체 DoD 검증·태스크 오케스트레이션 로직을 갖추고 있었다. 두 시스템을 합치려면 사실상 양쪽 다 다시 짜야 하는 수준이었다. 정면승부를 기각했던 것과 동일한 증거 기반 판단으로 이 옵션도 접었다.
정정 — 질문 하나가 멈춰 세우다
내 분석 초안을 검토하던 사람이 단순한 질문 하나를 던졌다.
"Compass는 n8n 같은 실행기가 아니라, 사실은 검증기 아니야?"
그 한마디에 이미 붙여놓은 카테고리 라벨 대신 Compass의 실제 API 표면을 다시 들여다보게 됐다. 그동안 비교해온 모든 경쟁 제품과 구분되는, Compass가 실제로 하는 일은 이랬다.
POST /workflows/{id}/validate
  → 정적 점검: ID 중복, 도달 불가능한 단계, 순환 참조,
    안전 규칙 커버리지 공백

POST /workflows/{id}/validate?ai=true
  → AI 의미 점검: 단계 의존성 논리 타당성, feasible:true/false 판정,
    누락 단계 자동 제안

POST /workflows/infer-step
  → AI가 완료 기준/재시도 정책/실패 경로를 추론 —
    "이 워크플로우가 실제로 완주 가능한가"를 실행 전에 답함
이 중 어느 것도 "이 자동화를 실행해줘"가 아니다. 전부 "실행하기 전에 이 워크플로우가 논리적으로 온전한지 알려줘"다. 이건 완전히 다른 제품 카테고리다 — 소스코드가 아니라 에이전트 워크플로우 그래프를 대상으로 하는 컴파일러의 정적 분석기, 혹은 린터에 훨씬 가깝다.
올바른 질문으로 다시 조사하기
바로잡힌 프레임으로 "노코드 자동화"가 아니라 "AI 에이전트 워크플로우 그래프의 실행 전 검증기"의 경쟁자를 다시 찾아 나섰다.
찾은 결과는 이랬다.
- 워크플로우 그래프의 정형 검증(model checking)(Kripke 구조, SPIN/TLA+ 같은 기법으로 데드락·도달불가 상태를 탐지하는 방식)은 성숙한 학술 분야이지만, 상용 소프트웨어로는 사실상 제품화된 사례가 없었다.
- 시장에서 가장 널리 쓰이는 에이전트 그래프 프레임워크는 그래프 시각화와 단계별 디버깅은 제공하지만, 도달 불가능한 노드를 자동으로 탐지하거나 제약 위반을 점검하는 기능은 없었다.
- 같은 생태계의 트레이스 평가 도구들은 실행이 끝난 결과물을 사후에 채점하는 것이지, 실행 전 그래프 자체의 구조적 건전성을 보는 게 아니었다.
- Policy-as-code 도구는 어떤 행동이 허용목록 안에 있는지를 점검하는 것이지, 그래프가 애초에 종료 상태에 도달할 수 있는지는 점검하지 않았다.
가장 결정적인 증거는, 바로 그 가장 널리 쓰이는 에이전트 그래프 프레임워크의 공식 저장소에 올라온 미해결 GitHub 이슈였다. "도달 불가능한 노드에 대한 컴파일타임 검증... 분리된 노드에 경고를 주거나 예외를 발생시키는 기능"을 명시적으로 요청하는 내용이었다. 이건 Compass가 이미 풀어놓은 문제를, 이 분야 최대 플레이어의 실제 사용자가 아직 해결이 안 됐다며 요청해놓은, 살아있는 미해결 기능요청이었다.
그래서 어떻게 했는가
Compass의 핵심 가치 제안을 다시 정의했다 — "워크플로우 자동화"가 아니라 "AI 에이전트 워크플로우 그래프의 실행 전 검증기/컴파일러." 타겟 사용자도 "노코드 자동화 빌더 사용자"에서 "에이전트 파이프라인을 프로덕션에 배포하기 전에 무한루프·도달불가 상태·규칙 위반을 사전에 잡아내고 싶은 AI 엔지니어링 팀"으로 옮겼다.
그리고 이걸 "검증됐다"고 단정하지는 않았다. 개발자 한 명이 남긴 GitHub 이슈 하나는 채워지지 않은 니즈의 증거이지, 시장 규모나 지불 의사의 증거는 아니다. 재포지셔닝 자체를 청신호로 받아들이는 대신, 그 생태계의 실사용자에게 직접 확인하는 실사용 신호 검증을 다음 필수 단계로 명시해뒀다.
내 제품이 어떤 카테고리에서 경쟁한다고 가정하느냐가 가격 정책, 타겟 고객, 심지어 이 프로젝트를 계속할 가치가 있는지까지 이후의 모든 판단을 좌우한다. 피치덱이나 첫인상이 아니라 실제 API 표면에서 포지셔닝을 다시 도출한 것 하나로, "과포화 시장이니 그만두자"는 결론이 "이 분야 최대 프레임워크에 실재하는, 아직 아무도 채우지 않은 빈틈"으로 바뀌었다. 여기서 중요했던 건 영리함이 아니라, 누군가 질문을 던진 순간 이미 써놓은 결론을 미련 없이 버리고 실제 코드와 문서로 다시 확인하러 가는 태도였다.
첫 댓글을 남겨보세요