그럴듯해 보이는 결과물을 만드는 생성 파이프라인이 사람 없이 운영해도 안전한 파이프라인과 같은 게 아니다 — '한 번 훑어봐서 괜찮아 보인다'를 신뢰할 수 없는 신호로 취급하고 매번 실행되는 검증을 설계해야 한다.
배경
[20편](./20-persona-pipeline-architecture.ko.md)에서 다룬 Project Persona의 5-레이어 아키텍처 중 레이어 2(오토클리핑/생성)는 사람이 매 프레임을 확인하지 않고 일정에 따라 자율적으로 결과물을 만들어낸다. 그게 이 시스템의 존재 이유지만, 그 말은 곧 생성 모델이 만든 결함이 사람의 눈 대신 다른 무언가가 잡지 않으면 그대로 실 채널로 나간다는 뜻이다.
트랙 B(AI아바타)가 실제 운영 물량으로 돌아가자 두 범주의 실패가 드러났다. 캐릭터 드리프트 — 이미지 생성 모델이 씬마다 새로운 확률적 추출이라 아무것도 기본적으로 시각적 연속성을 보장하지 않는 문제 — 와, 조용한 품질 결함 — 자막이 깨진 글리프로 렌더링되거나 오디오 라우드니스가 기준을 벗어나는, 스크립트로는 검증할 수 없는 방식의 오류. 업로드 전 검토하는 사람이 없다는 설계(20편) 자체는 의도적이었지만, 그 말은 존재하는 QC라면 뭐든 프로그램적이어야 하고 매번 실행돼야 한다는 뜻이었다.
첫 번째 결함 — 체이닝된 레퍼런스가 만든 드리프트
아바타 생성 로직의 첫 버전은 씬N의 레퍼런스로 씬N-1의 생성된 이미지를 사용했다 — 각 씬이 직전 씬에서 연속성을 물려받는다는 발상. 짧은 시퀀스에서는 동작했지만, 파쿠르 테마 에피소드에서 무너졌다. 4.5초, 7.5초 지점을 vision으로 검사하니 씬2와 씬3에서 캐릭터 머리에 동물 귀 같은 돌기가 자라나 있었다.
3단계 Why로 근본원인을 찾았다: 표면적으로는 이상한 귀 모양, 직접원인은 생성 코드가 각 씬을 이전 씬의 출력물에 체이닝한 것, 근본원인은 이미지 생성 모델의 image-to-image 모드가 "같은 캐릭터" 지시를 픽셀 완벽 재현이 아니라 확률적 재해석으로 지킨다는 것 — 체이닝 depth가 늘수록 재해석이 누적된다.
# Before: 씬이 늘어날수록 드리프트가 누적
prev_img = out_path
for scene in script["scenes"]:
    generate(prompt, prev_img, out_path, headers)
    prev_img = out_path

# After: 모든 씬을 원본 씬1 이미지에 고정 앵커
anchor_img = os.path.join(img_dir, "scene_1.png")
for scene in script["scenes"]:
    if scene["id"] == 1:
        continue
    generate(prompt, anchor_img, out_path, headers)
여기서 드러난 QC 사각지대도 있었다: 각 씬 이미지를 개별로 vision 검사했을 때 이미 "문제없음"이 나왔었다. 단일 이미지 검사는 일관성을 판단할 근거 자체가 없다 — 드리프트를 잡으려면 씬1 레퍼런스를 함께 제공하고 "원본과 일관되는가"라고 물어야지, "괜찮아 보이는가"만 물어선 안 된다.
조사 — 6개의 가설, 6번의 기각
앵커 방식이 동물 귀 문제는 해결했지만, 더 어려운 문제가 남았다: 액션 포즈(손 뻗기, 달리기, 뛰기)에서 팔다리 비율이 왜곡되는 현상. 여기에 조사 시간 대부분이 들어갔고, 이 과정을 정직하게 기록할 가치가 있다. 각 가설은 눈으로 확인한 표본이 아니라 동일한 자동 QC 체크(다수결 방식 체형비율 검사기)로 채점해서 검증했다.
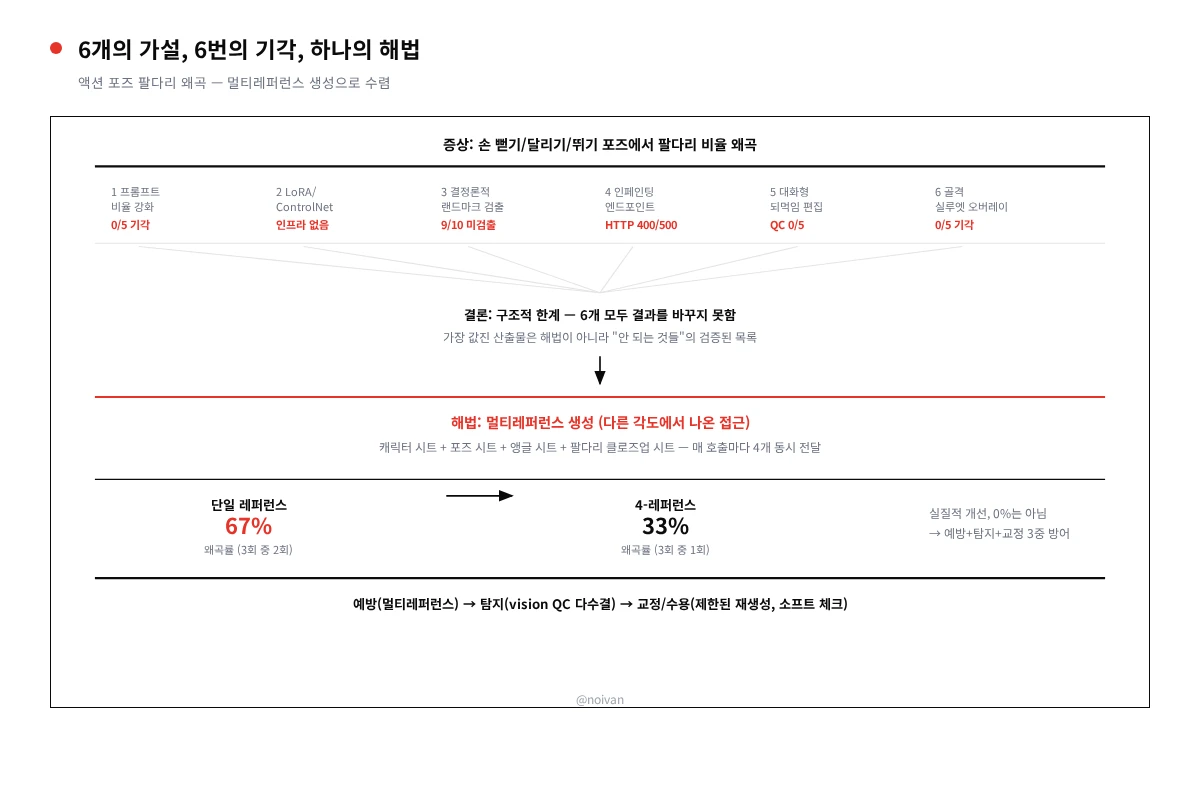
| # | 가설 | 결과 | |---|---|---| | 1 | 프롬프트 비율 지시 강화 | 0/5 통과 — 측정 가능한 변화 없음 | | 2 | LoRA 파인튜닝/ControlNet | 전용 GPU 학습 인프라 없어 기각 | | 3 | 결정론적 포즈 랜드마크 검출로 대체 | 10장 중 9장 검출 실패 — 양식화된 캐릭터에 일반화 안 됨 | | 4 | 인페인팅 엔드포인트로 팔다리만 재생성 | 3가지 인코딩 모두 HTTP 400/500 | | 5 | 대화형으로 되먹여 팔다리만 고쳐달라 요청 | API는 성공했지만 QC 0/5 통과 — 육안상 "나아 보임"은 재채점에서 살아남지 못함 | | 6 | 코드로 그린 비율 정확 골격 실루엣 추가 | 0/5 통과 — 기법은 개선했으나 비율 정확도는 그대로 |
여섯 가지 전부 결과를 바꾸지 못했기 때문에, 증상을 설정 문제의 증거로 취급할 근거가 없었다. 30건 이상의 실제 생성-QC 사이클 뒤 나온 결론은, 완전히 펼쳐진 팔다리를 요구하는 포즈가 프롬프트나 레퍼런스 문제가 아니라 이미지 생성 모델 자체의 구조적 한계에 부딪히고 있다는 것이었다. 이 조사에서 가장 값진 산출물은 해법이 아니라 잘 증명된 "안 되는 것들"의 목록이었다.
솔루션 — 멀티레퍼런스 생성
실제로 배포된 개선책은 여섯 가설과 다른 각도에서 나왔다: 단일 레퍼런스로 더 나은 출력을 억지로 끌어내는 대신, 캐릭터의 서로 다른 측면을 각각 커버하는 여러 레퍼런스를 동시에 제공하는 것. 매 생성 호출마다 메인 캐릭터 시트, 포즈 다양성 시트, 앵글 다양성 시트, 팔다리 클로즈업 시트 — 4개를 함께 전달했다.
가장 심하게 왜곡되는 포즈 유형에서 측정한 결과: 단일 레퍼런스는 3회 중 2회(67%)에서 심각한 왜곡을, 4-레퍼런스는 3회 중 1회(33%)에서 왜곡을 만들었다. 실질적이고 측정 가능한 개선이었지만 0%엔 도달하지 못했다 — 60건 규모의 후속 실험도 같은 패턴을 재확인했다: 정적이거나 중간 정도로 역동적인 포즈는 의미 있게 개선됐지만, 완전히 펼쳐진 팔다리를 요구하는 포즈는 레퍼런스 개수와 무관하게 사실상 100% 실패율에 머물렀다.
이 결과는 3중 방어 체계로 아키텍처를 안착시켰다: 예방(멀티레퍼런스 + 프롬프트 가이드), 탐지(모든 씬을 레퍼런스 대비 다수결로 채점하는 vision QC), 교정 또는 수용(제한된 자동 재생성, 그래도 실패하면 소프트 체크로 분류해 채널 전체를 막지 않음).
Before / After: 전체 프레임 QC vs. 표적 확대 재검증
또 다른 결함 범주는 완전히 다른 QC 사각지대에서 왔다. 자막 끝의 이모지가 깨진 글리프("tofu 박스")로 렌더링됐는데, 전체 프레임을 한 번에 본 vision 모델이 흐릿한 tofu 박스를 실제 이모지로 오독해 문제없다고 보고했다.
# Before — 전체 프레임 한 번 훑어보고 판정을 그대로 믿음
def check_subtitle_quality(frame_path, vision_client):
    result = vision_client.ask(image=frame_path, question="...")
    return result.lower().startswith("yes")

# After — 의심스러우면 해당 영역만 확대해 재검증
def check_subtitle_quality(frame_path, vision_client, subtitle_bbox):
    full = vision_client.ask(image=frame_path, question="...")
    if full.lower().startswith("yes"):
        cropped = crop_to_region(frame_path, subtitle_bbox, zoom=3.0)
        zoomed = vision_client.ask(image=cropped, question="...")
        return not zoomed.lower().startswith("yes")
    return False
근본원인은 구조적이었다: 자막 폰트가 이모지 글리프가 없는 한글 전용 서체였고, 프롬프트는 이모지를 피하라고 지시한 적이 없었다. 수정은 프롬프트 지시와 정규식 기반 이모지 제거기를 함께 적용했다 — 프롬프트 준수만 믿는 게 이미 다른 곳에서 신뢰할 수 없다고 드러났기 때문이다.
검증
오디오/비디오 QC도 같은 프로그램적 게이트 취급이 필요했다. 새 체크는 프레임 무결성, 정지구간 탐지(오탐 제거를 위해 임계값 재조정), 라우드니스 정규화(EBU R128/LUFS — 2-pass 정규화와 필터 체인 마지막 리미터 배치 필요), A/V 동기화를 확인했다. 5회 재빌드 뒤 파일럿 에피소드가 세 층 QC 전부를 통과했다: 피크 -2.41dB(클리핑 없음), 프레임 수 정확히 일치, 통합 라우드니스 -18.6 LUFS(허용범위 내), 효과음 동기화 오차 0.01초.
캐릭터 드리프트와 조용한 품질 결함을 관통하는 공통점은 같다: 대부분 그럴듯한 결과를 만드는 생성 파이프라인이 사람 없이 운영해도 안전한 파이프라인과 같은 게 아니라는 것. "한 번 훑어봐서 괜찮아 보인다"를 신뢰할 수 없는 신호로 취급하고, 실제로 관측된 실패 모드를 체크하며, 넓은 범위 체크가 애매하면 더 자세한 검사로 확대되는 검증을 설계하는 것이 실제 제품을 만든다는 것의 의미였다. 여섯 가설 조사도 마찬가지로 값진 기록이다: 각 이론을 실제 증거로 검증하고, 결과를 못 바꾸는 건 기각하며, 구조적 문제를 설정 수정으로 억지로 밀어붙이는 대신 "이건 다른 인프라가 필요하다"고 결론 낼 의지.
첫 댓글을 남겨보세요