생성 시점엔 정확히 '시뮬레이션'으로 표기됐던 지표가, 문서 간에 복사되면서 그 라벨을 조용히 잃어버려 결국 실제 현장검증 결과처럼 읽히게 될 수 있다.
배경
Sentinel이라는, 대상 애플리케이션에 자동화된 보안/QA 점검을 수행하는 AI 기반 플랫폼을 만들었다 — OWASP Web/LLM/API Top 10, 인증 결함, 인젝션 계열 등을 커버하는 수십 개의 전문 테스트 에이전트로 구성돼 있었다. 실제 테스트 에이전트와 함께, 효과성을 입증하기 위한 일련의 벤치마크 보고서도 쌓여 있었는데, 그중 여러 기획 문서에서 반복 인용되던 핵심 주장이 하나 있었다 — "AI 에이전트가 벤치마크 스위트 전반에서 사람 리뷰어보다 133~875배 빠르게 더 많은 이슈를 찾아냈다."
시작이 된 질문
누군가 단순하지만 불편한 질문을 던졌다. "이 QA 방법론, 프로세스, 에이전트 성능이 실제로 효과 있다는 게 진짜로 검증됐어?"
"코드가 실행되는가"가 아니라 "그 효과성 주장 자체가 진짜인가"였다. 그 주장들을 인용한 요약 문서를 믿는 대신, 모든 핵심 근거를 실제 소스 파일까지 직접 추적하기로 했다.
계층별로 확인한 사실
1. 사람 대비 비교 데이터는 100% 시뮬레이션이었다
벤치마크 스크립트의 "사람 데이터"는 하드코딩된 상수였다.
# benchmarks/human_baseline.py
human_data = {
    "findings_count": 1,
    "severity_accuracy": 0.8,
    "notes": "simulated senior human baseline",
}
생성된 모든 트라이얼 보고서(14개 파일, 개별 전수 확인)에 최상위 필드로 "simulated": true가 명시돼 있었다. 실제 사람 입력을 대화형으로 받을 수 있는 별도 스크립트가 존재하긴 했지만, 기록된 모든 보고서는 --simulate 플래그로 생성된 것이었고 실제 세션은 단 한 번도 없었다. 이 전체가 몇 달 전 약 두 시간 남짓한 시간대에 생성된 뒤 그 이후로 한 번도 손대지 않은 상태였다 — "실제 사람 트라이얼로 교체"하려던 계획이 조용히 실행되지 않은 것이었다.
이전 작업을 위해 공정하게 짚자면: 내부 벤치마크 보고서 자체는 이 스위트를 simulated senior analyst라고 정직하게 라벨링해뒀고, "알려진 한계" 섹션에도 이를 인정하는 내용이 있었다.
2. 그런데 그 단서가 외부용 초안에서는 사라져 있었다
이후 작성된 외부 공개용 런칭 전략 초안 — "실행 준비 완료" 상태로 표시된 — 에는 "simulated"라는 단어의 흔적이 전혀 없이, 마치 완료된 실제 연구처럼 서술돼 있었다.
"우리는 정식 벤치마크를 실행했다: 테스트 케이스 55건, 자동화된 프로브 결과를 동등한 수동 리뷰를 수행하는 훈련된 보안 엔지니어와 비교. 속도: 사람 리뷰어 대비 281배 빠름."
이대로 나갔다면 명백한 사실 왜곡이다 — 누군가 의도적으로 거짓말을 하려던 게 아니라, 정직했던 단서가 내부 보고서에서 외부 공개용 요약으로 옮겨지는 과정 어딘가에서 조용히 떨어져 나간 것이었다. 다행히 발견 시점까지 외부에 게시된 적은 없었는데, 이 사실이 "고친다"는 게 무엇을 의미하는지에 큰 영향을 줬다.
3. "실전 검증됐다"는 주장은 실제로는 패시브 HTTP 스캔이었다
실전 환경에서 검증된 발견물이라는 별개의 주장을 들여다보니, 실제로는 훨씬 작고 성격이 다른 테스트였다 — 공개 사이트 약 21곳에 평범한 HTTP 요청을 보내고 헤더/타이틀 문자열 몇 개가 일치하는지 확인하는 스크립트였다. 이건 진짜 결과이긴 하지만, "이 페이지가 로드되고 키워드를 포함하는가"를 측정하는 것이지 "우리가 실제 취약점을 발견하고 그 공로를 인정받았는가"가 아니다. 코드베이스와 이력 전체를 승인/심사/포상 관련 마커로 검색했지만 0건이었고, 제3자 프로그램에 자동 제출할 수 있는 인증정보도 어디에도 설정돼 있지 않았다 — 제출은 그때나 지금이나 전적으로 수동 프로세스다.
4. 자체 기준값을 외부 검증인 것처럼 인용하고 있었다
"목표 오탐률" 상수와 엄격한 품질게이트 함수는 둘 다 자기참조적이었다 — 이 시스템 자체의 내부 필터링 로직을 서술한 것이지, 그 필터링이 실제로 작동한다는 외부 확인이 아니었다. 그런 맥락 없이 인용하면 실제로는 존재하지 않는 종류의 검증을 암시하게 된다.
5. 같은 잣대로 감사했을 때 실제로 통과한 것들
모든 게 이 감사에서 실패한 건 아니었다. 별도의 더 작은 패시브 관찰 보고서(약 20개 사이트의 실제 HTTP 헤더)는 정확히 주장한 그대로였다 — 실제 요청, 과장 없음, "취약점 탐지"가 아니라 "헤더 존재 확인"으로 올바르게 라벨링돼 있었다. 플랫폼의 구조적 안정성 — 테스트 에이전트들이 크래시 없이 동작하는가 — 도 독립적으로 재검증됐고, 효과성 주장으로 부풀리지 않고 "크래시 없음"이라고 정확하게 보고돼 있었다.
취한 조치
- 외부 공개용 런칭 문서를 현재 상태로는 게시 불가로 표시하고, "simulated" 단서를 복원해야 할 구체적인 문장들을 특정했다 — 데이터 수정이 아니라 문서 수정이었다.
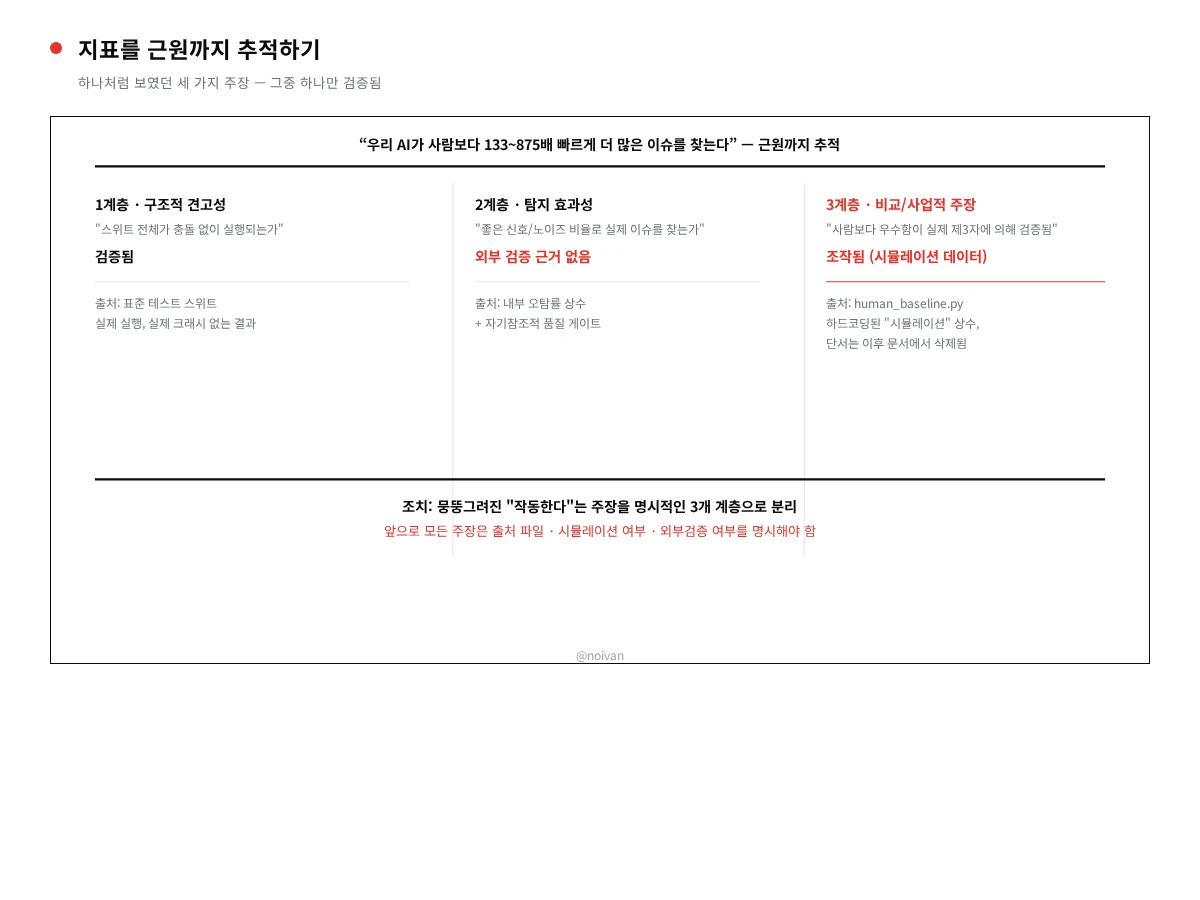
- 하나의 "효과 있다" 서사로 뭉뚱그려져 있던 세 가지 주장을 명시적으로 분리했다: (a) 구조적 건전성 — 검증됨. (b) 탐지 효과성(실전 신호 대 잡음 비율) — 외부 근거 없이 미검증. (c) 비교/사업적 주장(사람보다 빠르다, 실제 프로그램에 의해 검증됐다) — 핵심 자체가 조작됐고, 애초에 외부 검증이 전혀 존재하지 않았다.
- 향후 규칙을 제안했다: 앞으로 어떤 "N% 정확도" 또는 "검증됨" 주장이든, 외부 공개 문서에 쓰이기 전에 반드시 (1) 정확한 소스 파일, (2) 시뮬레이션 여부, (3) 외부 제3자의 확인 여부를 명시해야 한다.
가장 위험한 종류의 나쁜 지표는 틀린 숫자가 아니라, 정직하게 라벨링됐던 시뮬레이션 숫자가 문서를 옮겨 다니는 사이 조용히 그 라벨을 잃어버려서 결국 진짜 결과처럼 읽히게 되는 것이다. 자기 플랫폼의 마케팅 주장을 고객사 코드베이스를 감사할 때와 똑같은 엄격함으로 감사하는 건 불편한 일이지만, 그 대안은 그걸 다른 누군가로부터, 그것도 공개적으로 알게 되는 것이다. 여기서 고친 건 코드 패치가 아니라, 인상적으로 들리는 모든 숫자를 디스크 위의 실제 파일까지 끝까지 추적하고, "우리는 아직 그걸 모른다"고 기꺼이 결론 내리는 태도였다.
첫 댓글을 남겨보세요