증상을 임시로 덮는 대신 손상이 발생하는 실제 메커니즘까지 추적하면, '재작업 전략과 파일 포맷의 구조적 비호환'이라는 진짜 근본원인이 드러난다 — 라이브러리를 바꾸는 것도 API를 잘못 쓴 게 아니라 애초에 이 작업에 맞는 도구가 아니었기 때문이다.
배경
구매 결재를 라우팅하는 데 쓰이는 공식 결재양식을 기반으로, 특정 설비에 대한 4개 업체 견적을 나란히 비교하는 표를 만드는 작업이었다. 문제는 양식 자체였다 — 깨끗한 신규 파일이 아니라, 병합셀 16개, 외부 워크북 참조 21개, 레거시 배열수식을 포함한 수백 개의 정의된 이름(defined names)이 수년간 쌓인 레거시 Excel 파일이었다. 결과물은 버려지는 임시 산출물이 아니라 실제 결재·구매 프로세스에 그대로 투입될 파일이었다.
증상: "일단 지우고 다시 만들면 되겠지"의 실패
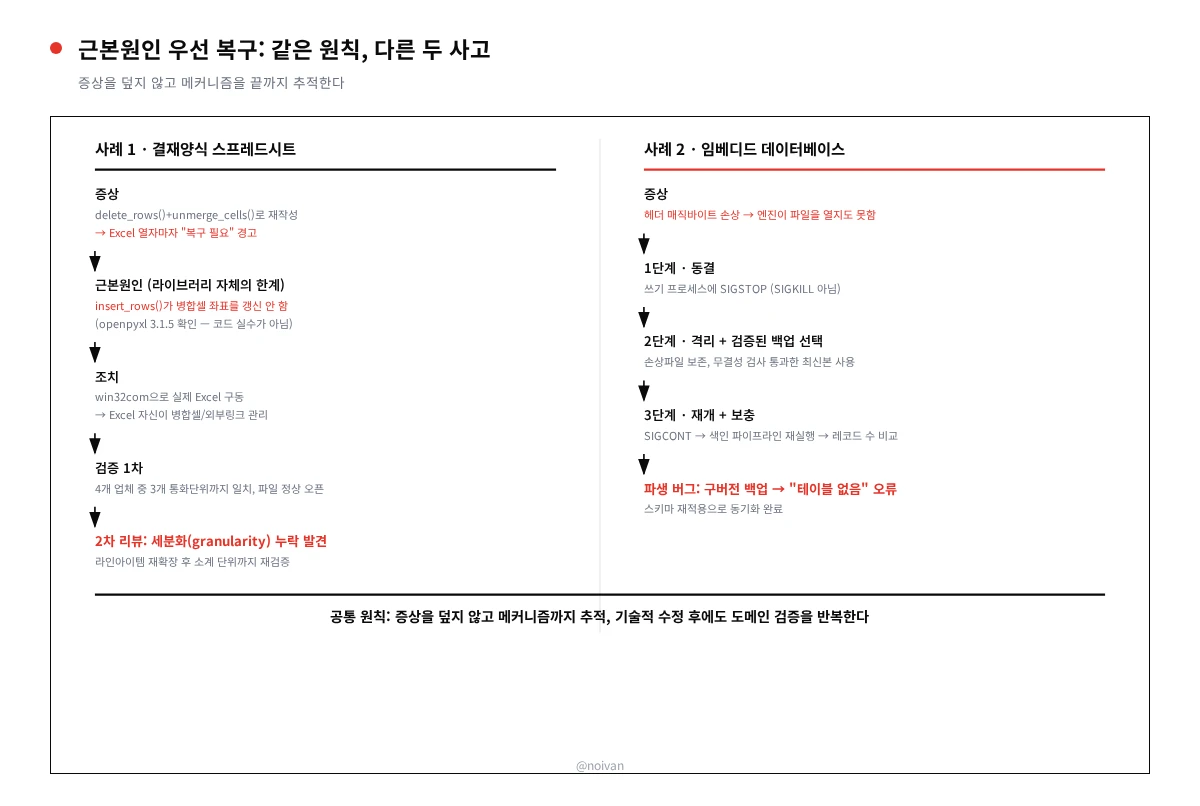
가장 빠른 길이 뻔해 보였다 — 원본 표의 자리표시용 행과 병합 영역을 openpyxl의 delete_rows()와 시트 전체 unmerge_cells()로 지운 뒤, 4개 업체 데이터로 표를 처음부터 다시 만드는 것. 결과 파일을 Excel에서 열자 즉시 "일부 콘텐츠에 문제가 있습니다... 복구를 시도하시겠습니까?"라는 경고가 떴다. Excel 자체 복구로 열 수는 있었지만, "자체 복구로만 열리는 상태"는 구매 결재 문서로 넘길 수 있는 수준이 아니었다.
조사: 근본 원인은 코딩 실수가 아니라 라이브러리의 한계였다
증상만 임시 처방하지 않고 손상 메커니즘을 끝까지 추적했다.
.xlsx는 XML 파트들의 zip 묶음이고, 병합셀 범위·외부링크·정의된 이름은 전부 그 XML 내부의 좌표를 서로 참조한다. 시트 전체에 대한 unmerge_cells()와 delete_rows()가 구조를 대거 다시 썼고, 다시 쓰인 XML이 외부링크 파트가 기대하던 것과 더 이상 맞지 않아 손상 경고가 뜬 것이었다. 별개로, 원본 양식의 Print_Area가 시트가 훨씬 작았던 시절의 고정 범위로 하드코딩돼 있어서, 실제 데이터가 그 경계를 넘어서자 일부 업체 열이 통째로 인쇄영역 밖으로 벗어나는 조용한 2차 버그도 발견했다 — 파일을 열 때는 에러가 안 뜨고 인쇄 결과물에서만 드러나는 종류였다.
더 안전한 방법(insert_rows())을 조사하던 중 세 번째이자 진짜 근본적인 발견이 나왔다: openpyxl.worksheet.worksheet.Worksheet.insert_rows()가 병합 영역 위나 내부에 새 행이 삽입될 때 기존 병합셀 범위의 좌표를 전혀 갱신하지 않는다는 것이었다(openpyxl 3.1.5에서 확인). 병합 영역 16개가 있는 이 시트에서는, 순수 openpyxl로 안전하게 행을 삽입할 방법 자체가 없었다 — 호출 코드를 잘못 짠 게 아니라 라이브러리 자체의 공백이었다.
조치: 실제 Excel을 COM으로 직접 구동
해결책은 .xlsx를 XML/zip 아티팩트로 조작하는 걸 그만두고, 병합셀·정의된이름·외부링크 관리를 내부적으로 담당하는 실제 Excel 애플리케이션을 Windows COM 자동화로 직접 구동하는 것이었다.
XL_SHIFT_DOWN = -4121  # xlShiftDown

def insert_rows_safely(worksheet, start_row: int, count: int):
    """정확히 필요한 만큼만 삽입한다. Excel 자신이 삽입을 실행하므로
    병합셀 범위, 정의된 이름, 외부링크를 항상 일관되게 유지한다."""
    target_range = worksheet.Rows(f"{start_row}:{start_row + count - 1}")
    target_range.Insert(Shift=XL_SHIFT_DOWN)
업체별 열 서식은 EntireColumn.Insert() 후 PasteSpecial로 복제했다. 그리고 이 양식에는 다시는 delete_rows()나 시트 전체 unmerge_cells()를 호출하지 않는다는 원칙을 못박았다.
검증 1: 재구성한 숫자를 원본까지 추적, 그리고 2차 수정
각 업체 총액을 서브시스템·카테고리별로 재산출해 원본 소스 문서와 교차 검증했다. 4개 업체 중 3개는 통화 단위까지 정확히 일치했고, 나머지 한 곳은 원본 문서에 이미 있던 반올림 표기로 추적되는 작고 고정된 차이였다 — 재구성 과정에서 새로 생긴 오류가 아니었다. 파일도 Excel에서 복구 안내 없이 깨끗하게 다시 열렸다.
하지만 여기서 끝이 아니었다. 원본 문서 구조를 실제로 아는 사람의 2차 리뷰에서, 첫 번째 "안전한 재작업"이 파일 손상은 고쳤지만 원본이 쓰던 세분화(granularity) 수준은 맞추지 못했다는 게 드러났다 — 개별 라인아이템 여러 개를 카테고리당 요약 한 행으로 뭉개버린 것이다. 4개 업체 전체 섹션을 최대 라인아이템 개수 기준으로 다시 확장하고, 완전히 펼친 버전이 첫 재작업과 동일한 총액으로 소계 단위까지 일치하는지 재검증했다. 기술적 손상을 고치는 것은 필요조건이지 충분조건이 아니었다.
사례 2: 손상된 임베디드 데이터베이스 복구
다른 사고, 다른 기술이지만 근본 원칙은 같았다. 축적된 지식 저장소를 담은 로컬 임베디드 데이터베이스 파일의 헤더가 손상됐다 — 파일 시작부 매직 바이트가 포맷 시그니처와 맞지 않아, 엔진이 파일을 열지도 못했고 무결성 검사조차 시도할 수 없었다.
피해야 할 나쁜 결과는 두 가지였다 — 데이터 완전 유실, 그리고 쓰기 프로세스가 여전히 접근 중인 상태에서 복원해 2차 손상을 일으키는 것.
- 쓰기 프로세스를 종료(
SIGKILL)가 아니라SIGSTOP으로 동결한다 — 상태가 찢어지지 않고 메모리도 보존된다. - 손상 파일은 삭제하지 않고 격리한다 — 나중 포렌식을 위해.
- 무결성 검사를 실제로 통과한 가장 최신 백업으로 복원한다 — 단순히 타임스탬프상 최신 것이 아니라, 후보들을 검증 쿼리로 하나씩 확인한 뒤 선택한다.
SIGCONT로 재개시켜 복원된 파일을 대상으로 이어가게 한다.- 수집/색인 파이프라인을 재실행해 백업 시점 이후 데이터를 보충하고, 복원 전후 레코드 수를 비교한다.
복원 과정에서 파생 버그도 하나 드러났다 — 사용한 백업이 이후 동기화 단계에서 쓰이는 어떤 테이블이 도입되기 이전 시점의 것이어서, 복원 후 첫 실행이 "테이블 없음" 오류로 실패했다. 스키마 정의를 직접 다시 적용해 동기화가 완료되도록 했다.
검증 2
- 무결성 검사 쿼리로 복원된 DB가 정상 오픈됨을 확인.
- 재실행한 색인 파이프라인 전후 레코드 수를 비교해 백업~손상 사이 누락분이 정확히 보충됐음을 확인.
- 파생 스키마 버그 수정 후 동기화 단계가 오류 없이 완료됨을 재확인.
두 사고 모두 같은 패턴을 따른다: 자동화된 무언가가 프로덕션 산출물을 망가뜨렸고, 해결책은 눈에 보이는 오류를 임시로 덮는 게 아니라 증상 너머 실제 메커니즘까지 파고드는 것이었다 — 한쪽은 재작업 전략과 레거시 파일 포맷 사이의 구조적 비호환성, 다른 쪽은 손상된 바이너리 헤더. 그리고 이건 덜 편하지만 더 유용한 태도도 보여준다: "이 접근 방식이 파일을 손상시켰고, 정확히 이런 이유였고, 그래서 방식을 바꿨다"고 말하는 것 — 조용히 다시 작업하고 아무도 눈치채지 않기를 바라는 대신. 이런 투명한 책임 인정과, 자동화의 출력을 믿는 대신 원본 데이터로부터 검증을 다시 쌓아 올리는 습관이 합쳐질 때, 실제 프로덕션 시스템을 안심하고 맡길 수 있게 된다.
첫 댓글을 남겨보세요