'슈퍼바이저가 RUNNING이라 한다'는 '실제로 원하는 트래픽을 처리 중이다'와 다른 주장이다 — 확실히 알 수 있는 유일한 방법은 커널에게 직접 어느 프로세스가 포트를 소유하는지 물어보는 것뿐이다.
배경
자체 운영 중인 인프라 스택이 있다 — 여기서는 Atlas라고 부르겠다. 표준적인 프로세스 슈퍼바이저가 관리하는 여러 상시 서비스로 구성돼 있다 — API 게이트웨이, 웹 채팅 프런트엔드, 브라우저 기반 코드 에디터, 웹훅 수신기. 모든 서비스는 여느 프로세스 슈퍼바이저처럼 RUNNING / FATAL / BACKOFF 상태를 보고한다.
증상
비슷한 시기에 두 건의 버그 보고가 들어왔다. 하나는 간헐적인 "database is locked" 오류, 다른 하나는 별개의 코드 리뷰 도구가 감사 시도 중 두 번이나 13분 넘게 멈춰서 강제 종료됐다는 것.
잘못된 가설을 세우고, 직접 검증해서 기각하다
처음엔 이 둘이 연관됐을 거라고 짐작했다 — 로컬 스택이 리소스 부족이라 외부 도구까지 느려진 게 아닐까 하고. 이걸 그냥 가정으로 두지 않고 직접 검증했다. 로컬 스택과는 완전히 무관한, 외부 도구 자체의 백엔드에 여러 번 독립적으로 호출을 걸어 시간을 측정했다. 응답 시간은 정상이었다(페이로드 크기에 따라 약 12초, 20초, 36초). 이걸로 공유 리소스 병목이라는 가설은 기각됐고, 두 사건은 비슷한 시기에 우연히 겹쳐 나타났을 뿐 하나의 근본원인이 아니라는 게 확인됐다.
조사
supervisorctl status를 더 이상 신뢰하지 않고, 운영체제에 직접 물었다 — 지금 이 포트를 실제로 누가 점유하고 있는가? /proc/net/tcp를 훑어 소켓 inode를 /proc/*/fd로 PID와 매칭시키면, 어떤 프로세스 관리자가 뭐라고 믿든 상관없이 진짜 답을 얻을 수 있다.
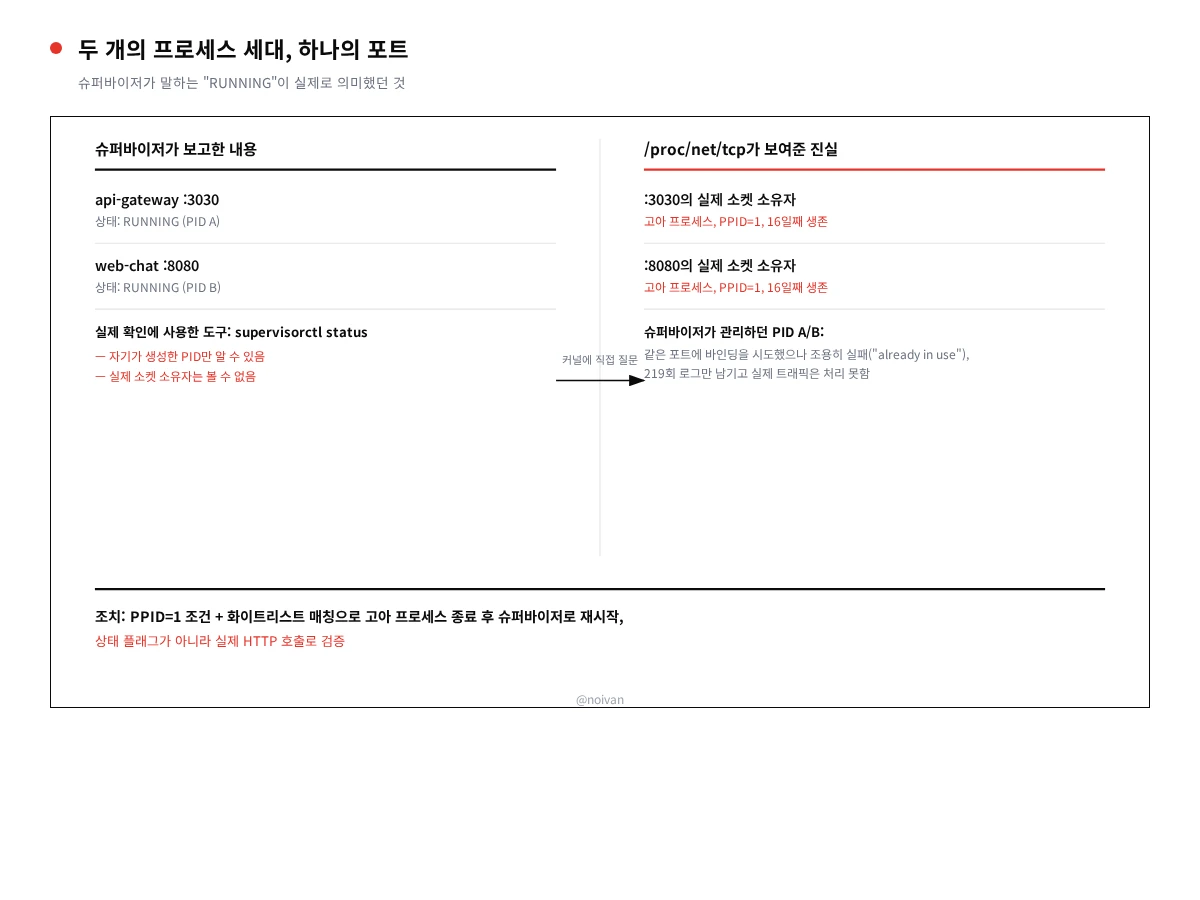
슈퍼바이저는 네 서비스 전부를 RUNNING으로 보고하고 있었다. 그런데 OS가 알려준 사실은 완전히 달랐다 — 네 포트 전부, 실제 소켓 리스너는 슈퍼바이저가 자기 것이라고 믿고 있는 PID와 다른 프로세스였고, 그 진짜 리스너들은 전부 PPID=1(고아 프로세스 — 원래 부모가 죽고 init에 입양됨)이었으며 2주 넘게 계속 실행 중이었다.
프로세스 슈퍼바이저 자체가 약 3주 전에 조용히 죽어 있었다 — 크래시 로그도, 알림도 없이 그냥 defunct 상태가 됐고, 그 자식 프로세스들은 정리되지 않고 PID 1로 재부모화됐다. 그 이후 새 슈퍼바이저 인스턴스가 기동돼서 각 서비스의 새 사본을 스폰하려고 성실하게 시도했지만, 모든 포트가 이미 죽은 세대의 고아 프로세스들에게 점유돼 있었다. 모든 스폰 시도는 바인딩에 실패해서 FATAL/BACKOFF로 로그를 남겼고... 그 사이 고아 좀비들은 계속 트래픽을 처리하고 있었다. 그래서 밖에서 보면 대체로 정상처럼 보였다.
포트 3030 (api 게이트웨이):
  좀비 고아 프로세스   PID 3576003   16일째, PPID=1   ← 실제로 서비스 중
  슈퍼바이저 관리 프로세스  PID 1391099   RUNNING       ← 포트를 바인딩한 적 없음
슈퍼바이저가 관리하던 프로세스는 실제로는 포트 충돌 때문에 기동 시점에 죽어있었고, "포트 이미 사용 중, 정상 종료" 로그를 219번 남겼다 — 그러니 "RUNNING"이라는 상태조차, 이미 자기 할 일을 포기한 프로세스를 보고하고 있었던 셈이다.
증상과 연결짓기
- "database is locked" 오류는 3주째 살아있는 좀비 게이트웨이 프로세스가 상태 데이터베이스의 파일 핸들을 계속 물고 있었다는 것과 정황상 일치했다 — 로그만으로 완전히 증명되진 않지만 강한 정황 증거였다.
- 13분 행 문제는 (위에서 독립적으로 검증했듯) 무관한 것으로 확인됐다 — 대신 외부 도구 자체 백엔드의 일시적 이슈로 추적됐고, 이건 이미 별개로 종결된 사안이었다.
조치
- 확인된 고아 프로세스들을 종료하고 포트 해제를 검증했다.
- 진짜 서비스를 슈퍼바이저 관리 하에 재기동하고, 각각 실제 요청으로 검증했다 — 단순 헬스체크 핑이 아니라 실제로 생성된 응답으로.
- 그 와중에 관련은 있지만 별개인 버그 하나를 더 발견해 고쳤다: 한 서비스의 슈퍼바이저 설정이 어떤 이름으로 환경변수를 설정하는데, 애플리케이션 코드는 이름이 다른 변수를 읽고 있어서 — 재시작할 때마다 설정된 토큰 대신 매번 새로운 무작위 접근 토큰을 조용히 생성하고 있었다.
- 항상 켜져 있는 작은 감시 프로세스를 만들었다: 실제 소켓을 점유한 PID와 슈퍼바이저가 믿고 있는 PID를 비교하고, 불일치하는 프로세스가 (a) 진짜 고아(PPID=1)이고 (b) 이 특정 서비스들에 대한 엄격한 명령줄 허용목록에 일치할 때만 조치한다 — 그런 다음 종료하고 슈퍼바이저가 포트를 되찾게 하고, 게이트웨이에 한해서는 HTTP 헬스체크까지 수행한다. 두 개의 독립된 스케줄로 돌아가서 슈퍼바이저가 다시 죽더라도 살아남는다.
검증
- 좀비를 종료한 지 몇 초 안에 네 포트 전부 해제되고 올바르게 재바인딩됐다.
- 상태 데이터베이스 쿼리 지연시간: 1밀리초 미만, 경합 없음.
- API 게이트웨이에 실제 요청을 보내 실제로 생성된 응답(HTTP 200)을 받았다 — 단순 헬스체크 핑이 아니라.
- 외부 코드 리뷰 도구를 세 번 재실행(간단한 쿼리, 파일 읽기, 약 385KB 파일 전체 감사) — 전부 정상 완료돼서 애초에 무관했다는 게 재확인됐다.
- 새로 만든 감시 프로세스가 PPID가 1이 아닌 워커 자식을 포크하는 정상적인 다중 프로세스 서비스에는 조치를 취하지 않는다는 것을, 감시 프로세스가 그렇게 동작할 거라고 가정하지 않고 실제 결정 로그를 읽어 확인했다.
"슈퍼바이저가 RUNNING이라고 한다"는 것과 "그 서비스가 당신이 생각하는 트래픽을 실제로 처리하고 있다"는 것은 같은 주장이 아니다. 프로세스 관리자는 자신이 스폰한 PID에 대해서만 알고 있다 — 그 스폰 시도가 이미 다른 무언가가 자원을 점유하고 있어서 조용히 실패했다면, 관리자의 대시보드와 실제 현실은 완전히 어긋나며, 상태 페이지의 그 어떤 것도 그 사실을 알려주지 않는다. 지금 이 순간 누가 그 자원을 실제로 점유하고 있는지 알아내는 유일한 방법은, 어떤 도구가 뭘 시작했다고 믿는지와 무관하게 커널에 직접 물어보는 것뿐이다. 따로 짚어둘 만한 점: 비슷한 시기에 도착한 두 버그 보고가 같은 근본원인을 공유하지 않았다는 것, 그리고 그 가정을 직접 검증해서 거짓임을 밝혀낸 것이 존재하지 않는 연결고리를 쫓느라 낭비될 뻔한 시간을 크게 줄여줬다.
프로세스 슈퍼바이저가 실제로 트래픽을 처리하지 않는 서비스를 RUNNING으로 보고한 이유는?
슈퍼바이저 자체가 약 3주 전 조용히 죽었고, 자식 프로세스들이 정리되지 않은 채 PID 1로 재부모화(고아 프로세스화)됐다. 새 슈퍼바이저 인스턴스가 각 서비스를 새로 스폰하려 했지만 고아 프로세스들이 이미 모든 포트를 점유하고 있어 매번 바인딩에 실패했고, 그동안 슈퍼바이저 대시보드는 실제로 아무것도 바인딩한 적 없는 프로세스를 계속 RUNNING으로 보고했다.
리눅스에서 실제로 어느 프로세스가 네트워크 포트를 소유하는지 확인하는 방법은?
/proc/net/tcp를 순회해 해당 포트의 소켓 inode를 찾은 뒤, 그 inode를 /proc/*/fd 아래의 열린 파일 디스크립터와 대조해 소유 PID를 찾는다 — 이는 어떤 프로세스 매니저가 무엇을 시작했다고 믿는지와 무관한 커널 차원의 진실을 준다.
첫 댓글을 남겨보세요