단일 AI 리뷰어의 '이론적으로 가능하다'는 지적은 결론이 아니라 단서일 뿐이다 — 실제로 PoC를 만들어 라이브 시스템에서 재현하기 전까지 보안 주장은 사실이 아니다.
배경
내가 관리하는 두 시스템에 주기적으로 보안/구조 감사를 돌리고 있었다 — 여러 팀이 매일 쓰는 사내 업무 우선순위 관리 도구(이하 Ledger)와, 웹 수집·클레임 검증 기능을 가진 리서치 자동화 파이프라인(Scout)이다. 둘 다 실제 사용자와 실제 산출물이 걸린 살아있는 시스템이라, 잘못된 판단은 어느 방향으로든 비용이 컸다 — 실제 취약점을 놓치는 것도, 모든 이론적 지적을 그대로 믿고 유령을 쫓느라 하루를 낭비하는 것도.
첫 시도의 한계
초기 감사는 회차당 서브에이전트 하나였다 — 정적 추론 패스이거나 실증 테스트 패스 중 하나였지, 한 회차에 둘 다는 아니었다. 성과는 있었지만(Ledger 이전 회차에서 이미 크리티컬 이슈 3건을 발견해 수정한 바 있었다), 반복되는 패턴이 있었다. 정적 리뷰가 "Y를 검증하지 않으므로 X가 이론적으로 가능하다"는 식의 지적을 내놓으면, 독립적인 검증장치 없이 나 혼자 그 경로가 실제 배포 환경에서 정말 끝까지 걸어갈 수 있는지 판단해야 했다. 일부는 진짜 심각했고, 일부는 정적 리뷰어가 볼 수 없는 계층에서 이미 차단되고 있었다. "지적된 모든 것을 고친다"도, "판단에 맡긴다"도 둘 다 만족스럽지 않았다 — 전자는 엔지니어링 시간을 낭비하고 회귀 위험을 만들고, 후자는 감사가 애초에 없애려던 단일 실패점 문제를 그대로 불러들인다.
재설계: 방법론이 다른 두 에이전트 + 필수 재현 관문
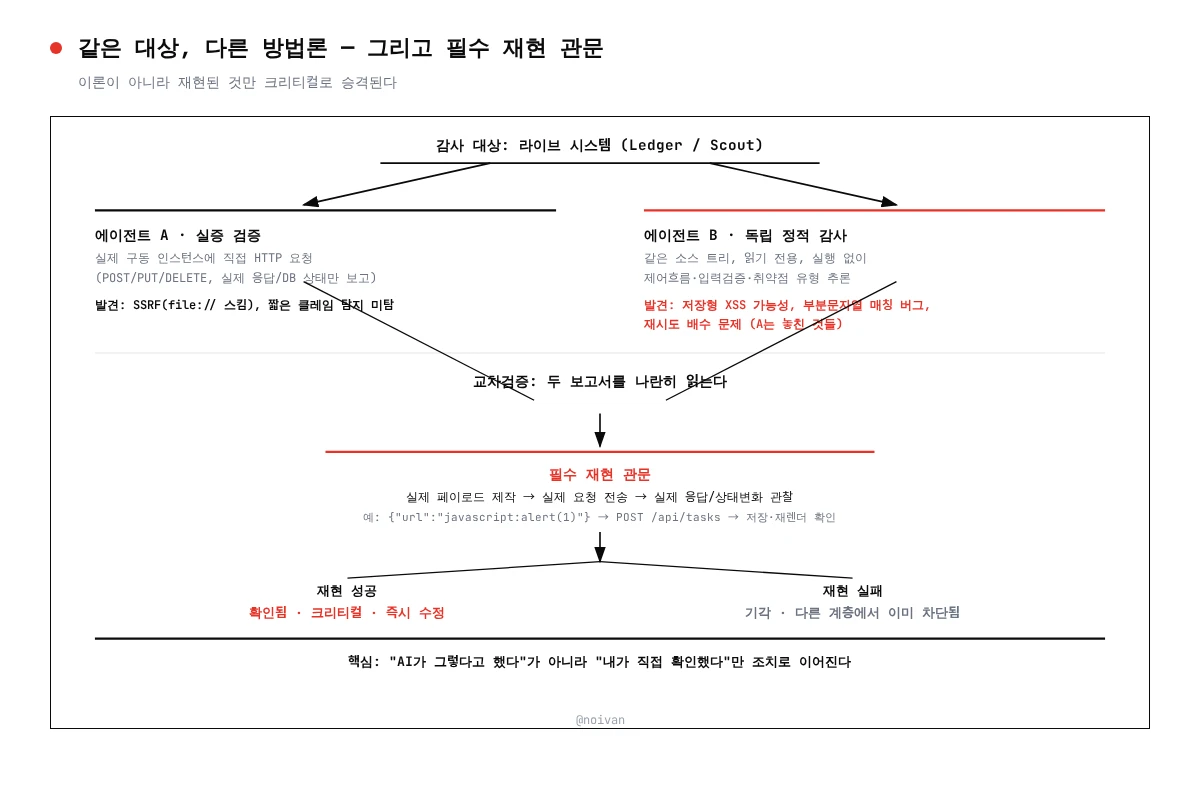
해법은 더 나은 프롬프트가 아니라 구조 자체를 바꾸는 것이었다. 한 에이전트가 주장을 찾기도 하고 검증도 하는 방식을 그만두고, 진짜로 다른 방법론을 가진 두 에이전트를 같은 대상에 투입한 뒤, 무엇이든 상위로 에스컬레이션되기 전에 반드시 재현 단계를 거치게 했다.
- 에이전트 A(실증): 구동 중인 실제 인스턴스에 실제 HTTP 요청(
POST,PUT,DELETE)을 보내고, 실제 응답과 이후 DB 상태만 보고한다. - 에이전트 B(독립 정적): 같은 소스 트리를 읽기 전용으로만 받아, 실행 없이 제어흐름·입력검증·알려진 취약점 유형을 코드만 읽고 추론한다.
- 교차검증: 두 보고서가 일치하면 신뢰도가 높다. B가 A는 테스트하지 않은 것을 제기하면, 나는 그 악용 가능성을 그대로 믿지 않고 직접 PoC를 만들어 실제 시스템에 쏴본다.
실전 사례: Ledger 하루 6차 감사
Ledger(SQLite를 PostgreSQL로 미러링하는 FastAPI 백엔드 + 단일페이지 프런트엔드) 대상 하루 6차 감사에서, 에이전트 B가 업무 레코드의 "링크" 필드가 URL 스킴 검증 없이 클라이언트단에서 렌더링된다고 지적했다 — 교과서적인 저장형 XSS 패턴이다. 과신("정적분석이 XSS라 했으니 바로 크리티컬")도 과소평가("이론일 뿐")도 라이브 공유 도구에는 받아들일 수 없었다. 그래서 직접 재현했다 — 실제 구동 중인 API에 {"url": "javascript:alert(1)"}를 담아 POST /api/tasks를 실제로 보냈다. 페이로드가 그대로 저장됐고 다음 페이지 로드 시 <a href="javascript:alert(1)">로 재렌더링될 상태임을 확인한 순간, "이론적으로 가능함"은 "확인됨, 크리티컬, 즉시 수정"으로 바뀌었다.
같은 6회차에서 발견한 두 번째 반복 패턴: main.py와 보조 스크립트 3개에 걸쳐, 쓰기 보호 키와 DB 비밀번호에 하드코딩된 리터럴 값으로 폴백하는 코드가 있었다(os.environ.get("WRITE_KEY", "기본값")). 겉보기보다 더 나쁜 이유는, 비밀 값이 한 번도 설정되지 않은 새 환경에서도 이 코드가 "작동"해버린다는 것이다 — 소스 트리에 평문으로 박힌 값으로 조용히 폴백하기 때문이다. 코드베이스 전체를 grep으로 검증해 이런 곳 4곳을 전부 찾아냈고(이전 회차가 이미 이 패턴을 한 번 놓친 적이 있었다) 전부 fail-fast로 전환했다. 그 외에도 전체 오리진을 허용하던 CORS 설정 강화, 버전관리가 전혀 없던 프로덕션 코드베이스를 git 관리하에 두는 작업, SQLite↔PostgreSQL 동기화의 타이밍 엣지케이스(> → >=)까지 같은 날 처리했다.
실전 사례: Scout에서 드러난 두 에이전트의 진짜 차이
같은 이중 에이전트 구조를 리서치 파이프라인 Scout에 적용했을 때, 둘의 독립성이 갖는 가치가 훨씬 명확히 드러났다 — 진짜로 서로 다른 것을 잡아냈기 때문이다.
실증 패스가 재현한 것: URL 수집기에 스킴 검증이 전혀 없어서 file:///etc/passwd가 https://와 동일하게 받아들여졌다(SSRF/로컬파일 유출, 크리티컬). 기본 HTTP 경로와 폴백 브라우저 경로 양쪽에서 각각 실제로 실행해 재현했다. 또한 짧은 클레임이 n-gram 윈도우 미만이라 탐지를 조용히 빠져나가는 미탐도 찾았다.
독립 정적 에이전트만 찾아낸 것: claim_id in body_text 검사가 "clm_1"을 "clm_10", "clm_100"의 부분문자열로 매치시키는 버그 — 클레임이 두 자리에 도달해야만 드러나는 문제라 소규모 테스트로는 실증 패스가 볼 수 없었다. 그리고 폴백 브라우저 수집기 자체에 내장된 재시도 3회가 파이프라인의 기존 재시도 로직 위에 겹쳐, 20초 타임아웃이 실패 시 거의 1분까지 조용히 늘어나는 문제도 잡아냈다.
내가 이미 직접 꼼꼼히 읽었던 코드베이스에서, 독립적인 2차 리뷰어가 5건 중 2건을 찾아냈다 — 이게 뛰어난 에이전트 하나가 아니라 방법론이 다른 두 에이전트가 필요하다는 구체적 증거다.
조치
SSRF 수정은 "먼저 재현하고, 심층방어로 고친다"를 가장 잘 보여준다. 진입점과 폴백 경로 양쪽 모두에 스킴 화이트리스트를 중복 적용했다 — 한쪽만 고치면 다른 경로가 여전히 뚫려 있기 때문이다.
ALLOWED_SCHEMES = {"http", "https"}

def _reject_unsafe_url(url: str) -> FetchResult | None:
    scheme = urlparse(url).scheme.lower()
    if scheme not in ALLOWED_SCHEMES:
        return FetchResult(status="error", verdict="unsafe_url", terminal=True, exit_code=2)
return Nonefetch()와 폴백 브라우저 함수 양쪽에서 독립적으로 이 검사를 호출한다 — 폴백 경로가 1차 경로 호출을 전제로 하지 않도록.
검증
- 저장형 XSS: 수정 후 원래 페이로드와 정상 링크를 함께 전송 — 악성 항목만 제거되고 정상 링크는 유지됨을 확인.
data:text/html,<script>와 잘못된 JSON으로도 반복 검증. - 하드코딩 인증정보: 환경변수 파일을 물리적으로 제거해 4개 파일 모두 명확한 오류와 함께 기동 거부함을 확인, 복원 후 정상 기동 재확인.
- SSRF: 원래의 두 PoC 페이로드를 재실행해 기본/폴백 경로 양쪽에서 exit code 2로 깔끔하게 거부됨을 확인, 정상
https://대상은 회귀 없음을 확인. - 클레임ID 매칭:
clm_1을 쿼리로, 원문에는clm_100만 있는 적대적 케이스를 구성해 오탐이 올바른 부정으로 바뀌었음을 확인. - 재시도 배수: 실패 케이스의 실제 경과시간을 측정해, 예측 불가능한 배수 대신 예측 가능한 약 11초로 줄었음을 확인.
단일 AI 리뷰어의 출력을 그대로 신뢰하는 대신 검증 시스템 자체를 설계하는 것 — 이게 이 작업이 보여주는 핵심 역량이다. 잘못된 판단의 비용이 비대칭적이면서도 실재하는 상황에서는 특히 그렇다. 두 개의 독립적인 방법론과, 에스컬레이션 전 필수 재현이라는 패턴은 보안 리뷰를 훨씬 넘어, AI 에이전트가 고위험 판단의 1차 패스를 담당하는 어떤 워크플로에도 일반화된다 — "AI가 그렇다고 했다"와 "내가 직접 확인했다"의 차이가 바로 여기서 갈린다.
첫 댓글을 남겨보세요