설정 우회, 모델 출력 형태에 대한 잘못된 가정, 낡은 스캐폴딩 파일, CLI 플래그 불일치 — 서로 무관한 버그 4개가 각각 조용히 실패하며 4개월짜리 가짜 성공 행진을 만들었다.
배경
여러 독립 프로젝트에서 다단계 자율 파이프라인을 돌리는 프레임워크를 만들었다 — 여기서는 Argus라고 부르겠다. 각 프로젝트는 여러 단계(phase)의 순서로 구성되고, 각 단계는 스크립트나 LLM 호출이며, 스케줄러가 하루 한 번 전체 시퀀스를 실행하고 결과를 진화 로그(evolution log)에 기록한다.
Argus 아래 등록된 프로젝트 중 하나가 Project Persona라는 콘텐츠 파이프라인이었다 — AI 캐릭터 콘텐츠 자동화 시스템으로, 성과 추적/콘텐츠 캘린더 생성/참여 타겟 발굴/자동 감사, 이렇게 4단계로 구성돼 있었다.
증상
Project Persona의 진화 로그를 보다가, 돌이켜보면 바로 눈에 띄었어야 할 사실을 발견했다. 전체 단계가 모두 성공한 기록이 정확히 두 번뿐이었고, 그 두 번 모두 프로젝트를 처음 설정한 첫 주에 몰려 있었다. 그 이후로 4개월 내내, 매일 1단계에서 조용히 실패하고 있었다. 연속 실패가 반복되면 자동으로 백오프하도록 설계된 쿨다운 메커니즘까지 작동해서, 이후의 자동 재시도조차 조용히 억제된 상태였다. 파이프라인은 시끄럽게 죽지 않았다. 그냥 아무 일도 하지 않으면서, 겉으로는 여전히 "스케줄링되어 있다"고 보였을 뿐이다.
이게 최악의 실패 유형이다 — 아무 알림도 안 울리고, 눈에 띄게 크래시하지도 않고, 멀리서 보면 정상적으로 설정된 것처럼 보인다.
근본원인 1 — 치환되지 않은 플레이스홀더
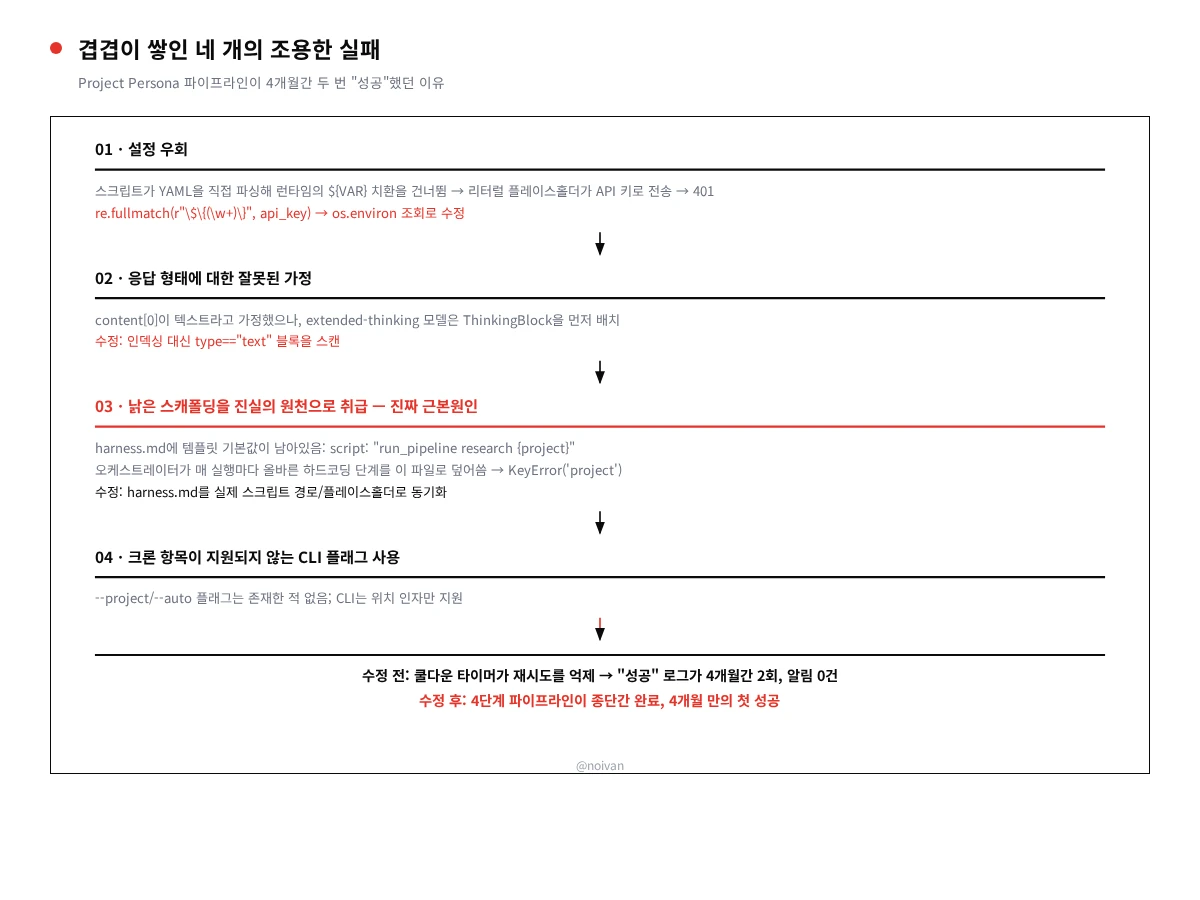
1단계는 LLM API를 호출하는 트렌드 수집 스크립트였다. 이 스크립트의 설정 로더는 YAML 파일을 직접 읽고 있었다.
# 수정 전 — services/trend_scout.py
def load_config():
    with open("config.yaml") as f:
        cfg = yaml.safe_load(f)
    return cfg  # api_key가 문자열 그대로 "${API_KEY}"로 돌아옴
Argus의 메인 런타임은 스크립트가 값을 보기 전에 ${VAR} 형태의 플레이스홀더를 치환해주는 자체 환경변수 치환 계층을 갖고 있다 — 하지만 이 스크립트는 설정 파일을 직접 파싱하며 그 계층을 완전히 건너뛰고 있었다. 매 호출마다 문자열 그대로 "${API_KEY}"가 API 키로 전송됐다. 즉시 401.
# 수정 후
def load_config():
    with open("config.yaml") as f:
        cfg = yaml.safe_load(f)
    api_key = cfg.get("api_key", "")
    m = re.fullmatch(r"\$\{(\w+)\}", api_key)
    if m:
        api_key = os.environ.get(m.group(1), api_key)
    cfg["api_key"] = api_key
    return cfg
근본원인 2 — 새 모델에서 깨진 응답 구조 가정
API 키를 고쳤다고 파이프라인이 살아나지는 않았다. 다음 실패는 이랬다.
AttributeError: 'ThinkingBlock' object has no attribute 'text'스크립트는 response.content[0]이 항상 텍스트 답변이라고 가정하고 있었다. 그런데 어느샌가 조용히 업그레이드된 모델 버전은 extended thinking을 지원했고, 사고 모드가 켜지면 content[0]은 모델의 내부 추론 과정일 수 있으며 실제 텍스트 블록은 리스트 뒤쪽에 있을 수 있었다.
# 수정 전
text = response.content[0].text

# 수정 후
text = next(
    (b.text for b in response.content if getattr(b, "type", None) == "text"),
    ""
)
근본원인 3 — 진짜 원인: 프로덕션에 그대로 남아있던 스캐폴딩 템플릿
두 가지를 다 고쳐도 1단계는 여전히 죽었다. 이게 찾는 데 가장 오래 걸린 원인이었다. 스크립트 안이 아니라, 이 프로젝트에서 어떤 스크립트가 어느 단계에서 실행되는지 선언하는 파이프라인 자체의 명세 파일 안에 있었기 때문이다.
그 파일에는 프로젝트를 처음 만들던 날 작성된 스캐폴딩 템플릿이 그대로 남아있었는데, 오케스트레이터가 실제로는 지원한 적 없는 플레이스홀더 문법을 쓰고 있었다.
# harness.md (Project Persona) — 최초 설정 이후 한 번도 갱신 안 됨
phases:
  - name: research
    script: "run_pipeline research {project}"   # {project}가 채워지지 않음
Argus는 이 파일을 단계 정의의 진실source로 취급해서, 자기 자신이 이미 갖고 있던 올바른 하드코딩 단계 스크립트를 이 파일 내용으로 매 실행마다 덮어쓴다 — 이 오래된 플레이스홀더까지 포함해서. 매 실행마다 cmd_tmpl.format()이 KeyError: 'project'로 즉시 실패했고, 이건 앞의 두 수정과 무관하게 벌어지는 문제였다. Argus에 등록된 다른 모든 프로젝트는 스캐폴딩 파일을 실제 스크립트와 동기화해뒀는데, Project Persona만 한 번의 초기 설정 단계가 조용히 영구적인 지뢰로 남아있었던 것이다.
# harness.md — 실제 하드코딩된 단계 스크립트와 일치하도록 수정
phases:
  - name: research
    script: "python3 pipeline/trend_scout.py --project-dir {projects_dir}/persona"
수정을 재등록하다 발견한 네 번째 버그
크론 항목 자체가 CLI가 지원한 적 없는 플래그(--project X --auto)로 호출되고 있었다 — CLI는 위치 인자(run <project> / auto <project>)만 받았다. 이 작업은 매일 "존재"하고 "실행"됐지만, 그저 인자 파싱에서 에러가 났을 뿐이었다. 앞의 세 가지 이유로 파이프라인이 이미 1단계에서 죽어있었기 때문에 아무도 이걸 눈치채지 못했다.
검증
네 가지를 모두 수정한 뒤, 실제 실행이 처음부터 끝까지 깔끔하게 완료됐다.
[persona] Phase 1 (60s): trend_scout.py                → rc=0, 1.11s
[persona] Phase 2 (60s): content_calendar.py            → rc=0, 0.04s
[persona] Phase 3 (60s): engagement_target_finder.py    → rc=0, 0.08s
[persona] Phase 4 (90s): automated_audit.py             → rc=0, 0.02s
[persona] evolution log: 전 단계 성공 (4개월 만에 처음)
이 실행에서 1단계 하나만으로 실제 데이터 70건 이상을 수집·분석했다 — 스모크 테스트가 아니라 완전한 프로덕션 실행이었다.
서로 무관해 보이는 네 개의 버그 — 설정 우회, 모델 응답 구조 가정, 진실 source로 취급된 낡은 스캐폴딩 파일, CLI 플래그 불일치 — 는 각각 조용하고 이른 단계에서 실패했기 때문에 개별적으로는 눈에 띄지 않았고, 사람이 볼 수 있는 곳 어디에도 알림이 뜨지 않았으며, 거기에 쿨다운 타이머가 재시도까지 조용히 억제했다. 여기서 일반화할 수 있는 원칙은: "메인" 런타임의 공유 치환/검증 계층과 별개로 자기만의 설정/명세를 읽는 파이프라인 컴포넌트는 반드시 사각지대가 된다는 것이다. 공유 컨벤션이 바뀌는 순간 이 스크립트가 따로 놀고 있었다는 걸 아무도 기억하지 못한 채 어긋나기 시작한다. 조용한 실패와 자동 백오프의 조합은, 시스템이 "나 포기했어"라고 크게 알리지 않는 한 위험하다.
첫 댓글을 남겨보세요