'서비스는 멈추면 안 된다'를 리팩토링 순서를 결정하는 하드 제약으로 다루면, 완전 재작성 없이도 4,000줄짜리 파일을 안전하게 쪼갤 수 있다 — 매 단계마다 수치 회귀 0건을 직접 검증하면서.
배경
생산라인 위 56대 CNC 설비의 사이클타임(CT)을 실시간으로 추적하는 웹 대시보드(이하 CT 플랫폼)를 직접 구축·운영했다. 생산 DB에서 데이터를 집계하고, 이탈을 탐지하고, 설비 간 NC 프로그램 버전을 비교하는 기능까지 담고 있었다. 첫 버전은 당연하게도 모든 걸 다 하는 단일 FastAPI 파일이었다 — DB 연결, 백그라운드 폴링 스레드, HTTP 라우트, NC diff 로직이 전부 한 스크립트에 들어있었다. 담당자들 앞에 빠르게 동작하는 결과물을 내놓을 수 있었던 초반에는 이 방식이 맞았다.
증상
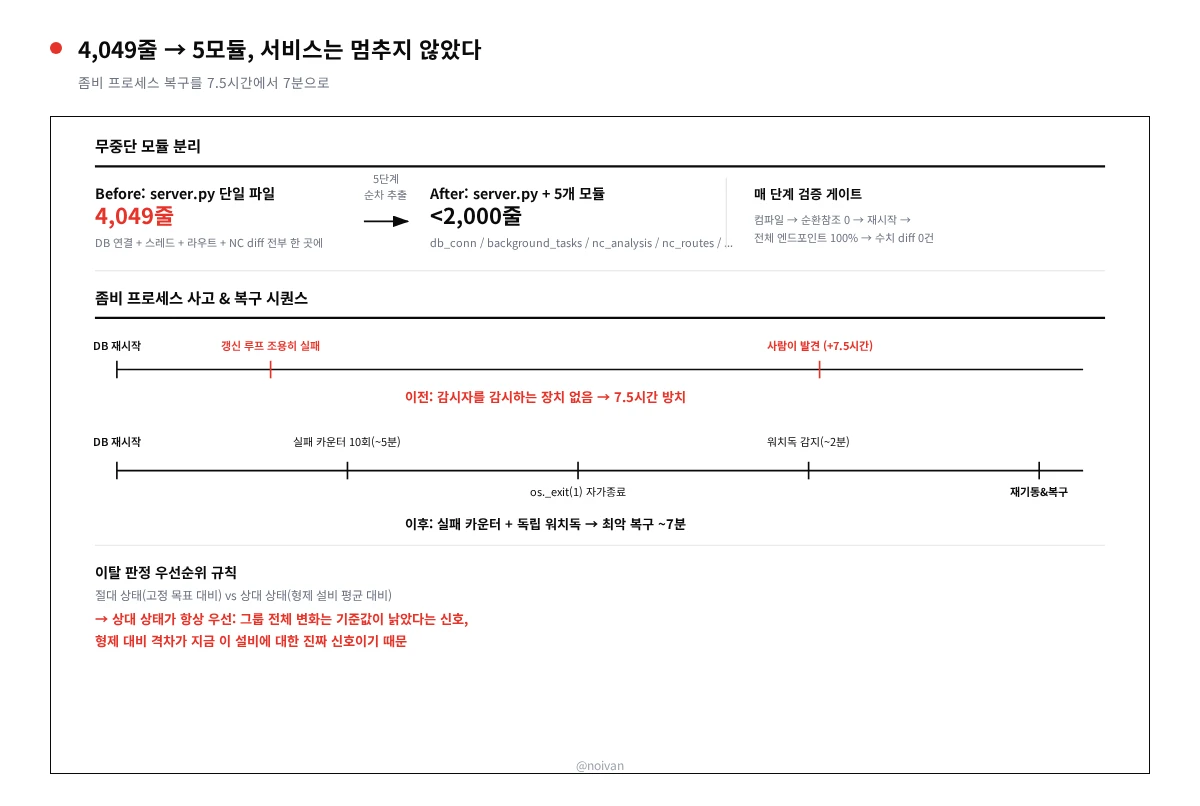
파일이 4,049줄을 넘어서면서 문제가 누적됐다. 관련 없는 로직을 스크롤로 헤치고 지나가야 손댈 수 있었고, 손대지 않은 부분에서도 회귀가 쉽게 생겼다. 그러다 결정적인 사고가 터졌다 — 기반 생산 DB가 잠깐 재시작되자, 대시보드의 백그라운드 갱신 루프가 반복적인 쿼리 타임아웃에 부딪혔다. 프로세스는 크래시하지 않았다. OS 관점에서는 계속 "살아있는" 상태였지만, 실제로는 데이터를 전혀 갱신하지 못하는 좀비 상태로 약 7.5시간 방치됐다. 감시자를 감시하는 장치가 아예 없었기 때문이다.
조사: 좀비 프로세스의 실제 타임라인
앱 로그와 에러 로그를 재구성해보니 이런 순서가 드러났다: DB 세션 끊김 → 갱신 루프가 조용히 실패 시작(경고 로그 없이) → DB 자체가 하드 재시작됨 → 대시보드는 완전히 다른 연결 상태가 된 DB를 상대로 몇 시간째 계속 재시도. 원인은 단일 버그가 아니라, "실패해도 죽지 않는다"는 설계 자체의 공백이었다.
동시에 도메인 로직 쪽도 감사했다. 대시보드는 각 설비의 사이클타임을 고정 목표값 대비, 그리고 형제 설비들의 실시간 평균 대비 이탈로 분류하는데, 현장 엔지니어들의 관찰과 대조해보니 두 가지 버그가 숨어 있었다. 하나는 우선순위 충돌 — 한 설비가 동시에 "절대적으로 빠름"이면서 "상대적으로 느림"으로 읽힐 수 있었는데, 어느 상태를 화면에 보여줄지 규칙이 없었다. 다른 하나는 기준값 오계산 — 여러 공정군의 고정 목표값이 실제 설비 대수·실측 타이밍이 아니라 범용 대당 시간 가정치로 계산돼 있어서, 정상 설비를 이탈로 잘못 표시하거나 반대로 진짜 느린 설비를 놓치고 있었다.
조치 1: 복원력 시스템 구축
수정은 단일 패치가 아니라 작은 시스템이었다.
- DB 연결 타임아웃을 120초에서 30초로 줄였다 — 120초는 멈춘 쿼리 하나가 전체 루프를 "실패"가 아니라 "바쁨"으로 보이게 만들기 충분한 시간이었다.
- 모든 백그라운드 갱신 호출 지점에 공유 실패 카운터를 추가했다. 30초 주기 기준 연속 10회 실패(약 5분)가 나면, 프로세스가 스스로
os._exit(1)을 호출한다. - 독립적인 2분 주기 워치독이 포트가 리스닝 중인지, 헬스 API가 실제로 응답하는지를 함께 확인한다. 프로세스 존재 여부만 보는 게 아니다.
이 조합으로 최악의 복구 시간을 약 7분(실패 카운터 5분 + 워치독 감지 2분)으로 묶었다 — 사람이 발견하는 데 7.5시간 걸렸던 것과 대비된다.
도메인 로직 쪽도 확정된 규칙으로 정리했다: 상대 상태(형제 대비)가 절대 상태(고정 목표 대비)보다 항상 우선한다 — 그룹 전체의 변화는 대개 기준값 자체가 낡았다는 신호이지만, 형제 대비 격차는 지금 이 설비에 대한 진짜 신호이기 때문이다. 기준값도 실제 설비 대수와 실측 데이터 기반으로 다시 계산했다.
조치 2: 무중단으로 4,049줄을 쪼개기
이 프로젝트에서 가장 흥미로웠던 결정은 새 기능이 아니라, 서비스가 계속 돌아가는 상태로 코드베이스 자체를 재구성한 방식이었다. 완전한 재작성은 리스크가 너무 컸다 — 이 파일이 담당자들의 실제 현장 의사결정을 지탱하고 있었다. 대신 작고 독립적으로 검증 가능한 추출 작업을 순서대로 진행했다.
- DB 연결 계층을 가장 먼저 별도 모듈로 추출 — 다른 것에 의존하지 않아 위험도가 가장 낮았다.
- 백그라운드 스레드를 의존성 주입 방식으로 추출 — 서버 전체를 import하지 않아도 테스트 가능하도록.
- 순수 분석 함수(NC diff 등)를 부수효과 없는 모듈로 추출.
- 라우트를
APIRouter로 추출하되, 결합도가 높은 라우트는 억지로 깔끔하게 만들려 하지 않고 함수 내부에서만import server as S를 호출하는 의도적인 "지연 참조" 패턴을 썼다.
# nc_routes.py — 라우터는 정말 필요할 때만 메인 모듈을 되돌아 참조
@router.get("/api/nc_compare")
def api_nc_compare(machine_a: str, machine_b: str):
    import server as S  # 지연 import: 로드 시점의 순환참조 회피
    files_a = S.fetch_nc_files(machine_a)
    files_b = S.fetch_nc_files(machine_b)
    return nc_analysis.compute_nc_diff(files_a, files_b)
각 추출 단계는 완료 판정 전에 동일한 검증 순서를 거쳤다: 신구 파일 컴파일 확인 → 순환참조 없음 확인 → 실제 프로세스 재시작 → 모든 API 엔드포인트 호출해 100% 성공 확인 → 모든 공장 라인 출력을 알려진 정상값과 diff해 수치 회귀 0건 확인. 이걸 통과한 뒤에야 다음 단계로 넘어갔다.
검증
- 복구 시간: DB 장애부터 대시보드 복구까지 종단간 측정 — 최악의 경우 약 7분으로 상한.
- 리팩토링 정확성: 다섯 단계 추출마다 회귀 테스트가 모든 엔드포인트를 호출(12/12 통과)했고, 모든 공장 라인 사이클타임 수치를 diff — 매 단계 수치 변화 0건.
- 리팩토링 규모: 메인 파일이 4,049줄에서 2,000줄 미만으로, 약 52% 감소 — 제거된 로직은 사라진 게 아니라 다섯 개 모듈 안에 그대로 있음을 전량 추적.
- 독립 감사: 후속 구조 감사가 순환참조(0건), 심볼 완전성, 라우트 커버리지를 점검 — 발견된 사소한 이슈 2건도 리팩토링 이전 백업본에 이미 존재해 신규 회귀가 아님을 확정.
- 2호기 라인 확장: 동일 아키텍처를 두 번째 생산라인에 적용할 때, 기존 라인의 전/후 API 응답을 키 단위로 diff해 행동 변화 0건을 확인했고, 새 라인의 목표 사이클타임은 실측 평균값과 대조 검증했다.
이 작업은 영리한 알고리즘 하나에 관한 이야기가 아니라, 시스템이 계속 커지는 동안에도 정확성을 유지하는 규율에 관한 이야기다. "서비스는 멈추면 안 된다"를 리팩토링 순서를 결정하는 하드 제약으로 다뤘지, 리팩토링을 피하는 핑계로 쓰지 않았다. 그리고 가장 가치 있었던 수정들은 일반적인 소프트웨어 패턴이 아니라, 황삭과 정삭이 물리적으로 다른 가공 단계라는 것을, 혹은 직전 20사이클+직후 20사이클 기준이 가장 보기 좋은 샘플 두 개를 고르는 것보다 "정상"을 훨씬 정직하게 측정한다는 것을 이해해야만 나올 수 있는 수정들이었다. 깔끔한 코드를 넘어 실제 도메인 지식을 시스템 설계에 녹여내는 것 — 그것이 담당자들이 이 도구의 경고를 실제로 믿고 행동에 옮기게 만든 요인이다.
첫 댓글을 남겨보세요